
Поднять Temporal и написать первый workflow — час работы. Держать его в проде — набор отдельных навыков, которые в туториалах опускают: как настроить ёмкость воркеров, чтобы задачи не копились; что мониторить, чтобы заметить застрявший процесс раньше пользователя; как тестировать процесс, который логически идёт сутки.
Начнём с симптома, который чаще всего толкает оптимизировать не то: «Temporal тормозит» нередко означает «не хватает ёмкости воркеров», и отличить одно от другого можно замером.
В статье
- Главный симптом: schedule-to-start
- Замер: что даёт расширение воркера
- Что этот замер доказывает, а что нет
- Два семейства метрик
- Что алертить
- Тестирование: промотка времени
- Cloud или self-host
Главный симптом: schedule-to-start
Из четырёх таймаутов activity один говорит не о работе, а о ёмкости: ScheduleToStart — время от появления задачи в очереди до момента, когда её подхватил воркер.
Растущий schedule-to-start означает буквально следующее: задачи созданы, а свободного воркера для них нет. Сервер при этом может быть совершенно здоров. Снаружи же это выглядит как «Temporal медленный», и оптимизировать в такой ситуации начинают не то.
Замер: что даёт расширение воркера
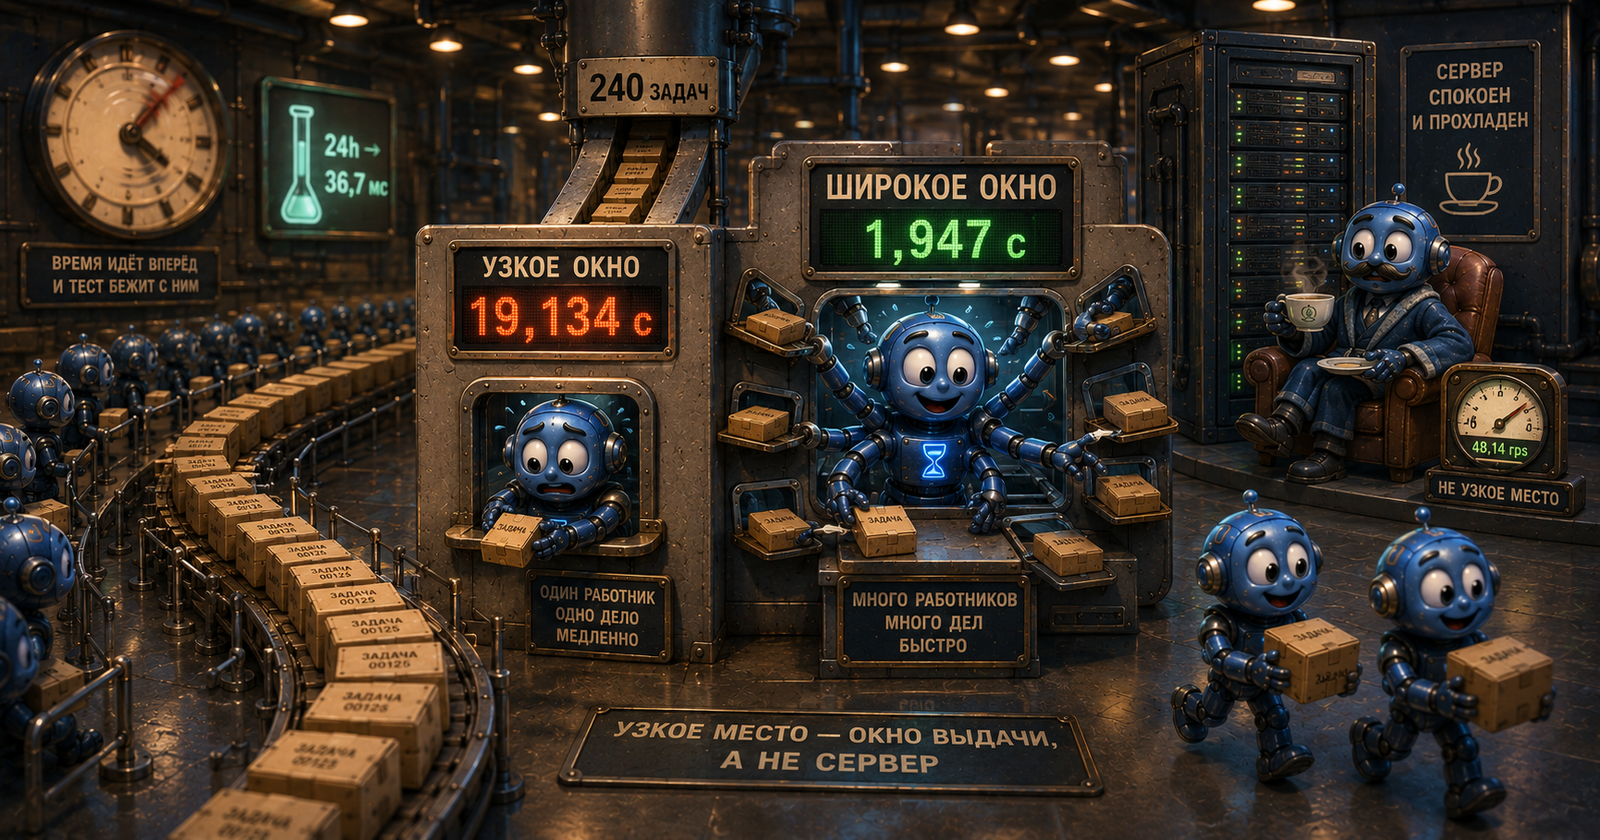
Нагрузка фиксирована: 4 процесса по 60 activity — 240 задач во всех конфигурациях. Меняется только настройка воркеров.
| Конфигурация | Полное время | schedule-to-start среднее | медиана | максимум |
|---|---|---|---|---|
| 1 воркер, ёмкость 2, pollers 2 | 38,21 с | 18,683 с | 18,821 с | 37,869 с |
| 1 воркер, ёмкость 20, pollers 4 | 4,11 с | 1,774 с | 1,869 с | 3,796 с |
| 2 воркера, ёмкость 20, pollers 4 | 2,23 с | 0,835 с | 0,936 с | 1,912 с |
Откуда числа. Ожидание каждой из 240 задач — по отметкам сервера: activity возвращает StartedTime − ScheduledTime из activity.GetInfo, и среднее, медиана и максимум считаются по всем задачам прогона. Полное время — тоже по серверу: от старта первого процесса до закрытия последнего. Для сверки рядом снимается среднее по sum/count метрики SDK — с обоих воркеров там, где их два, и только после проверки, что SDK насчитал все 240 задач. Во всех трёх конфигурациях оно совпало с серверным до миллисекунды.
Расширение одного и того же воркера — с ёмкости 2 до 20 — сократило среднее ожидание с 18,7 до 1,8 секунды, то есть в 10,5 раза. Второй воркер дал ещё в 2,1 раза — ровно столько, сколько следует из удвоения суммарной ёмкости.
Максимум в первой строке — 37,9 секунды при прогоне в 38,2: последняя задача ждала почти весь прогон. Она была поставлена в очередь в самом начале, а подхвачена в конце. Это и есть очередь в чистом виде.
Первая редакция этой таблицы брала максимум запросом max() по ряду temporal_activity_schedule_to_start_latency_seconds. Но Tally, через который Go SDK отдаёт метрики, экспортирует эту величину как Summary с квантилями, и наибольший из квантилей — не наибольшее ожидание отдельной задачи, так что называть его максимумом было неверно. В той таблице «максимум» к тому же превышал длительность прогона: 39,5 секунды при 38,8. Отчего именно, я отдельно не устанавливал, а полное время тогда снималось клиентом, не сервером. Среднее по sum/count от этой ошибки не страдает: сумма и число в Summary точные.
Каждая величина включает накладную стенда — сотни миллисекунд на сетевой обмен, — и на неё стоит сделать поправку при чтении отношений: аддитивная составляющая, одинаковая в абсолюте, отношения искажает. При 18,7 против 1,8 секунды она погоды не делает, при 2,4 против 2,0 уже делала бы.
Замер сделан по одному прогону на конфигурацию. Для порядков этого достаточно, для второго знака — нет.
Что этот замер доказывает, а что нет
Доказывает он ровно одно: в исходной конфигурации ограничителем был воркер. Расширение воркера при неизменных сервере и нагрузке дало десятикратное сокращение ожидания — значит, до расширения упирались именно в него.
Чего он не доказывает:
- что сервер не был узким местом одновременно. Ограничителей может быть несколько, и снятие одного просто выводит систему на следующий;
- что сервер не стал узким местом после расширения. Двукратный выигрыш от второго воркера об этом ничего не говорит ни в одну сторону: суммарная ёмкость выросла вдвое, и вдвое сократилось ожидание — так и должно быть, пока ограничивает воркер. Признаком другого предела было бы, если бы удвоение ёмкости дало заметно меньше двух раз;
- что 42 запроса к persistence в секунду — это «мало». Число без ёмкости, утилизации и latency хранилища не говорит ни о чём: оно описывает нагрузку, а не запас.
Чтобы утверждать «сервер не насыщен», нужны его собственные величины — utilization пула соединений, latency персистентных операций и их динамика под ростом нагрузки. На стенде этого нет, и заявлять это в статье было бы натяжкой.
Практический шаблон отсюда всё же следует, только формулировать его надо аккуратнее: расширение компонента, меняющее результат, доказывает, что этот компонент ограничивал — и ничего не говорит про остальные. Поиск узкого места поэтому и итеративен: снимаете один, меряете заново, находите следующий.
Два семейства метрик
У Temporal метрики приходят из двух мест, и имена у них похожи настолько, что перепутать легко.
| Кто отдаёт | Что видно | |
|---|---|---|
| Метрики SDK | ваш воркер | schedule-to-start, попадания в sticky-кэш, latency проигрывания, ретраи activity |
| Метрики сервиса | роли Temporal | нагрузка на persistence, latency запросов, состояние очередей внутри сервера |
Часть величин существует только в одном из семейств. Счётчик попаданий в sticky-кэш есть исключительно у SDK: сервер про кэш воркера не знает вообще — это разбиралось в статье про архитектуру.
Отсюда правило, которое стоит завести с самого начала: у каждого числа в отчёте фиксируйте, чем оно снято. Одинаково названные метрики из разных семейств отвечают на разные вопросы, и вывод из перепутанных источников получается противоположным.
Ещё одна ловушка того же рода — отсутствие ряда. Если метрика ни разу не сработала, ряда в Prometheus нет вовсе, и это не то же самое, что ноль. Запрос, молча вернувший пустоту, легко принять за «значение нулевое», хотя правильное прочтение — «событие ни разу не произошло».
Что алертить
- schedule-to-start — первый по важности. Растёт → не хватает воркеров либо очередь не та.
- Застрявшие процессы. Исполнение в состоянии Running с workflow task, падающей по кругу с растущим номером попытки, — это расхождение при проигрывании. Процесс жив, метрики старта в порядке, прогресса нет. Без отдельного алерта это состояние может держаться сутками.
- Всплеск неретраибельных ошибок и таймаутов activity.
- Latency persistence. Сервер стоит на хранилище; его деградация проявится во всём сразу.
- Отставание visibility. Индексация асинхронна: список исполнений может отставать от факта.
Распределённый трейсинг через границы workflow заслуживает отдельного внимания: асинхронные границы рвут наивно проброшенный контекст, и это та же проблема, что разобрана в статье про трейсинг на практике.
Тестирование: промотка времени
Процесс, который логически идёт сутки, невозможно протестировать вживую. Тестовое окружение SDK перематывает таймеры: Sleep(24 часа) не ждёт ничего.
На стенде такой тест проходит за 36,7 миллисекунды реального времени.
Одна деталь в устройстве этого теста важнее самой промотки. Тест меряет собственную длительность и падает, если она превысила порог. Без этой проверки он был бы зелёным и при сломанной перемотке — просто выполнялся бы сутки, а в CI отвалился бы по таймауту раннера, где причину уже не разглядеть. Утверждение «проходит мгновенно» должно быть проверено, а не подразумеваться.
Второй инструмент — replay-тесты против сохранённых историй. Они не требуют ни сервера, ни воркера и ловят ломающие изменения до выката. В связке с версионированием это основная защита от расхождений в проде.
Выгодный контраст с самодельным оркестратором из первой статьи: проверить, что самописный автомат корректно восстанавливается после падения на каждом из шагов, — отдельная работа, требующая базы и подстроенных состояний. Здесь это два теста без внешних зависимостей. Подробнее про подходы — в статье про тестирование распределённых систем.
Cloud или self-host
Self-host означает, что ваша команда отвечает за persistence, visibility, обновления сервера, мониторинг и ёмкость. Стенд этой серии — прод-подобный по топологии, но это одиннадцать контейнеров, из которых Elasticsearch — отдельная система со своими требованиями к памяти.
Temporal Cloud снимает операционную часть, добавляя стоимость и привязку к провайдеру. Критерии выбора обычные: зрелость команды в эксплуатации stateful-систем, объём нагрузки, требования к расположению данных.
Честно про стоимость: durable execution — не бесплатный обед. Считать надо не только инфраструктуру, но и людей — и сравнивать не с нулём, а с тем, во что обходится самописный оркестратор с его таблицей состояний, ретраями и восстановлением после сбоев, который придётся писать и поддерживать вместо этого.
Что осталось за рамками
Эта статья про ту часть эксплуатации, которую видно с места разработчика: ёмкость воркеров, метрики, тестирование, выбор между Cloud и self-host. Полная эксплуатация Temporal шире, и перечислить недостающее честнее, чем оставить впечатление, что его нет:
- обновление сервера и миграции схемы persistence;
- резервное копирование и восстановление, проверка восстановимости;
- retention и архивация историй — прямо связаны с версионированием, где снятие патча упирается в срок хранения;
- корректное завершение воркера при выкатке, чтобы задачи не обрывались на полпути;
- аутентификация, авторизация и мультитенантность через namespace, квоты на namespace;
- отказоустойчивость и репликация между регионами, план восстановления;
- runbook’и на типовые инциденты.
Каждый из пунктов тянет на отдельный разбор со своим стендом.
Демо и версии
Стенд: digital-cookbook/architecture/temporal, профиль 06-operations — три конфигурации ёмкости воркера при фиксированных 240 задачах, метрики SDK в Prometheus, тест с промоткой времени.
Версии прогона: Temporal Server 1.29.7, Go SDK v1.46.0, Prometheus v3.7.3. Набор метрик зависит от версии SDK и сервера.
Документация и первоисточники
- Канон: Worker performance, Observability, Testing, Temporal Cloud.
- Смежное на сайте: Temporal — обзор, архитектура Temporal, версионирование workflow, распределённый трейсинг на практике, тестирование распределённых систем, Temporal по языкамготовится, с 27 октября.

Комментарии