
Из обзорной статьи Temporal выглядит как «сервер + воркеры»: воркер подключается, выполняет workflow и activity, сервер хранит состояние. Для оценки применимости этого достаточно, но для эксплуатации — нет. За «сервером» скрываются четыре отдельных сервиса со своими обязанностями, персистентное хранилище со своей моделью данных, отдельный store для поиска и механика task queues, на которой держится вся маршрутизация работы.
Эта статья разбирает Temporal изнутри: что где живёт, как шардируется исполнение, что происходит физически при вызове activity. Все утверждения ниже проверены на стенде, где четыре роли подняты отдельными контейнерами — это позволяет гасить их по одной и смотреть, что при этом видно снаружи.
В статье
- Четыре сервиса
- Что будет, если убрать history
- Что физически лежит в persistence
- Visibility живёт отдельно
- Task queues изнутри
- Sticky execution и цена его отсутствия
- Путь запроса целиком
- Где узкие места
Четыре сервиса
«Temporal Server» — это четыре роли, которые могут работать в одном процессе, а могут быть разнесены:
| Роль | За что отвечает |
|---|---|
| frontend | точка входа gRPC, маршрутизация запросов, rate limiting |
| history | сердце: хранит и продвигает состояние исполнения, пишет журнал событий, ведёт таймеры |
| matching | сводит задачи из task queue с воркерами, которые их слушают |
| worker | системные фоновые задачи самого Temporal — не путать с вашими воркерами |
Последняя строка — источник регулярной путаницы. Внутренний worker-сервис занимается архивацией, репликацией и системными воркфлоу Temporal; ваши воркеры к нему отношения не имеют и живут вообще вне сервера.
Что будет, если убрать history
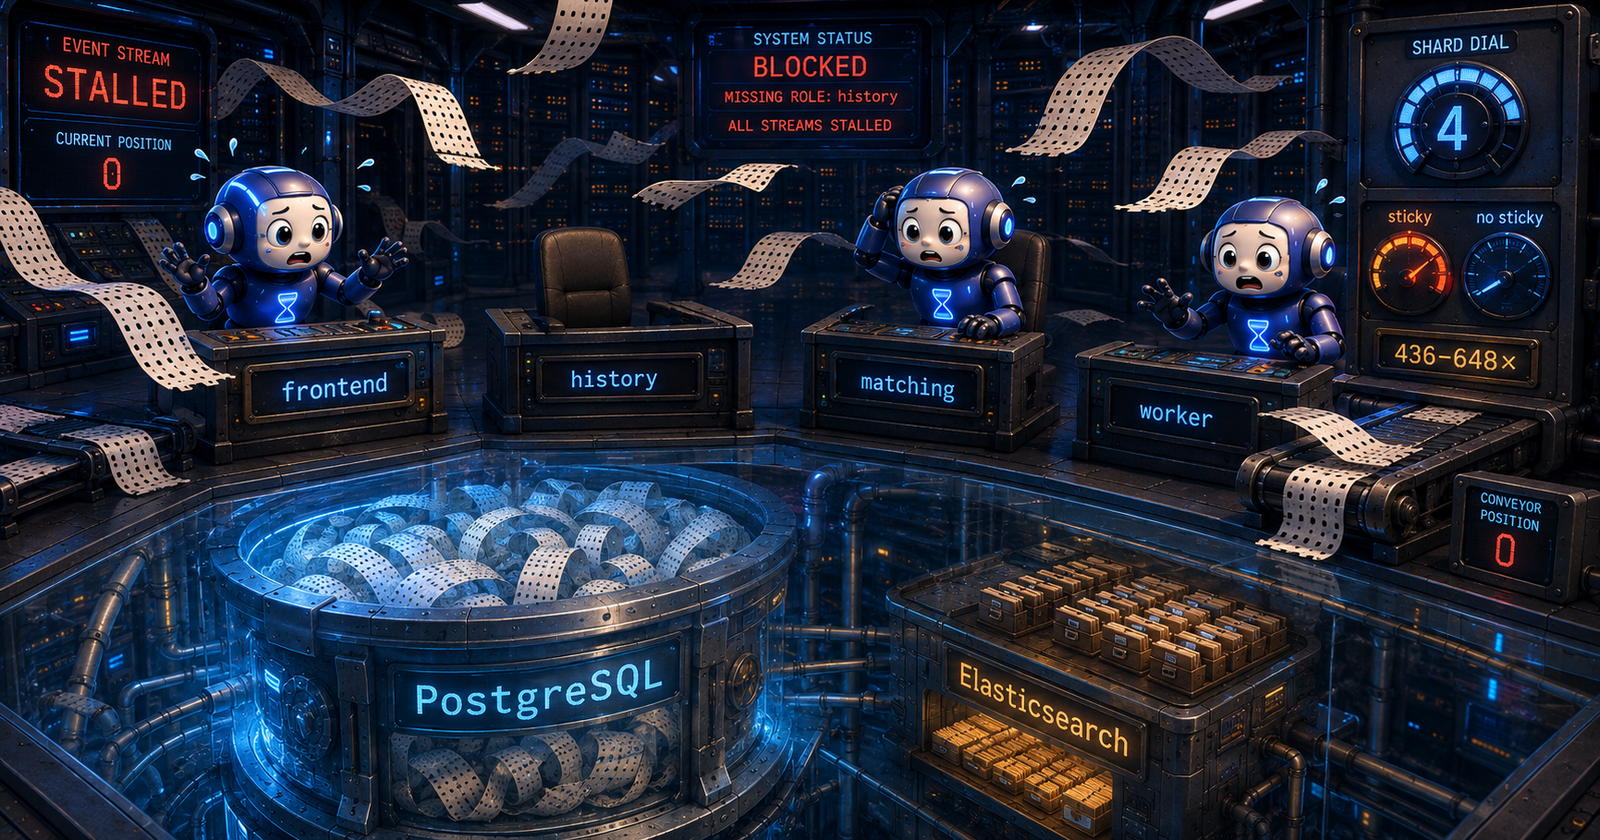
Роли можно перечислять сколько угодно, но их разделение становится осязаемым, только когда одну из них выключают. На стенде под нагрузкой гасится только history.
| Момент | Выполнено activity |
|---|---|
| до гашения | 3 |
| сразу после гашения | 3 |
через 30 секунд без роли history |
3 |
| через 45 секунд после возврата роли | 117 |
Прирост за тридцать секунд без роли — ноль. После возврата — плюс 114.
Читать это надо внимательно: воркфлоу не упали, не перешли в состояние ошибки и не начались заново. Они не продвигались. Роль, владеющая их шардами, отсутствовала — и продвижение состояния стало невозможно, потому что именно history записывает события и двигает исполнение вперёд.
Отсюда практический вывод для эксплуатации: history — не «одна из ролей», а та, чья недоступность выглядит как полная остановка обработки при формально живом frontend. Запрос на старт воркфлоу при этом может приниматься, а прогресса не будет.
Что физически лежит в persistence
В PostgreSQL стенда после прогона двух профилей:
| Величина | Значение |
|---|---|
| Шардов history | 4 |
Размер таблицы history_node |
3 384 kB |
Записей в history_node |
8 046 |
Абсолютные величины здесь зависят от того, сколько исполнений успело отработать: срез сделан на стенде, поднятом начисто. Инвариантно другое — число шардов, оно задаётся конфигурацией развёртывания.
Таблицы, которые создаёт Temporal, читаются по названиям: executions (текущее изменяемое состояние исполнения), history_node и history_tree (сам журнал событий), activity_info_maps и child_execution_info_maps (состояние вызванных activity и дочерних воркфлоу), history_scheduled_tasks и history_immediate_tasks (внутренние очереди задач самого сервера), shards, cluster_membership.
Разделение на «журнал» и «изменяемое состояние» здесь принципиально: history_node растёт и никогда не переписывается, а executions хранит текущий снимок. Это та же пара, что в Event Sourcing — журнал и проекция, — и durability стоит на транзакционности хранилища, как в разборе WAL и надёжности БД.
Шардирование
Исполнения распределены по фиксированному числу history shards. У каждого шарда один владелец среди экземпляров history-сервиса. Отсюда два следствия, о которых лучше знать заранее:
- число шардов задаётся при развёртывании и не меняется без миграции — это решение принимается один раз;
- масштабирование history — это перераспределение шардов между экземплярами, а не дробление нагрузки внутри одного шарда.
Visibility живёт отдельно
Список исполнений, поиск и фильтрация — это не журнал. За них отвечает отдельное хранилище.
На стенде с ENABLE_ES=true в индексе Elasticsearch лежит 37 документов, а таблицы executions_visibility в PostgreSQL нет вовсе. Последнее — не косвенный признак, а прямое доказательство: при включённом Elasticsearch схема visibility в SQL-хранилище просто не ставится.
Практически это означает, что у Temporal два хранилища с разными требованиями, и терять их надо тоже по-разному. Потеря persistence — потеря исполнений. Потеря visibility — потеря возможности искать и перечислять, но не самих исполнений: их состояние по-прежнему в persistence.
Task queues изнутри
Task queue в Temporal — не топик Kafka: у неё нет офсетов, повторного чтения и нескольких независимых потребителей одного и того же потока. Воркеры слушают её долгим опросом, и дальше возможны два пути.
Быстрый — sync match. Если в момент появления задачи на очереди уже висит свободный поллер, matching отдаёт задачу ему напрямую, не записывая её в хранилище. Это основной путь на живой нагрузке, и именно он делает Temporal быстрым.
Медленный — backlog. Если свободного воркера нет, задача сохраняется в task queue в persistence и ждёт там. Ровно это происходит в замере из статьи про эксплуатациюготовится, с 26 октября, где узкий воркер набирал очередь на десятки секунд: задачи никуда не делись, они лежали и ждали.
Различие практическое: пока работает sync match, нагрузка на persistence от очереди минимальна; как только воркеры перестают успевать, к записи истории добавляется запись задач, и хранилище получает нагрузку с двух сторон одновременно.
Задачи бывают двух видов, и путать их не стоит:
- workflow task — «продвинь исполнение»: воркер получает историю, проигрывает код и возвращает список новых команд;
- activity task — «выполни вот эту activity»: воркер выполняет обычный код с побочными эффектами.
Разные очереди можно отдавать разным пулам воркеров — например, вынести тяжёлые activity на отдельную очередь и отдельные машины. Это же основной инструмент управления ёмкостью, разбор которого — в статье про эксплуатациюготовится, с 26 октября.
Sticky execution и цена его отсутствия
После первой workflow task воркер оставляет состояние исполнения в памяти и просит присылать следующие задачи ему же. Это и есть sticky execution. Если кэша нет, воркер на каждой workflow task проигрывает историю с начала.
Замер на стенде: одинаковая нагрузка (5 исполнений по 40 шагов, 405 workflow task), различается ровно размер кэша, порядок конфигураций чередуется по раундам.
| Конфигурация | Попаданий в кэш | Replay на задачу | Полное время (медиана) |
|---|---|---|---|
| кэш включён | 400 из 405 | 3,9–4,1 мкс | 41 446–41 637 мс |
| кэш выключен | ряда нет | 2 610,2–2 629,6 мкс | 41 735–43 449 мс |
Отношение — от 637× до 674×. Это метрика SDK воркера: сервер про его кэш ничего не знает, и с серверной стороны эта величина не видна в принципе.
Два вывода, которые нельзя смешивать
Первый. Sticky-кэш убирает полное проигрывание истории на каждой задаче, и в своём инструменте эффект — три порядка.
Второй. В полном времени исполнения этого эффекта не видно: 41,4–43,4 секунды в обеих конфигурациях. Разброс внутри одной и той же конфигурации больше, чем разница между конфигурациями: у варианта без кэша два раунда дали 41 735 и 43 449 миллисекунд.
Объяснение простое и его стоит держать в голове при любом замере такого рода. При истории в четыре сотни событий проигрывание стоит миллисекунды, а один сетевой обмен на этом стенде — сотни миллисекунд. Искомый эффект на три порядка меньше шума.
Первая версия этого замера мерила именно полное время и показала «эффекта нет». Это был верный результат неверно выбранного инструмента — и хорошая иллюстрация того, почему у каждого числа стоит спрашивать, чем оно снято.
«Ряда нет» — это не ноль
В таблице выше у конфигурации без кэша в графе попаданий стоит «ряда нет», а не ноль. Разница существенная: счётчик temporal_sticky_cache_hit_total при выключенном кэше не существует — событие ни разу не произошло, и метрика не создана. Записать сюда ноль означало бы утверждать, что измерение было и дало нулевой результат.
Цена проигрывания растёт с длиной истории линейно; числа и следствия — в статье про детерминизм и replay.
Путь запроса целиком
Собирая всё вместе, старт исполнения выглядит так:
StartWorkflow
  → frontend        принимает запрос
  → history         создаёт исполнение, пишет первое событие
  → matching        публикует workflow task
  → ваш воркер      проигрывает код, возвращает команду «выполни activity»
  → history         записывает событие о планировании activity
  → matching        публикует activity task
  → ваш воркер      выполняет activity, возвращает результат
  → history         записывает результат в журнал
  → …               и так до завершения
Каждая стрелка — сетевой обмен и, для history, запись в хранилище. Отсюда понятно, откуда берётся накладная на шаг и почему durable execution не годится для latency-критичных путей.
Где узкие места
- История шардов. Число шардов фиксировано при развёртывании; упереться в него означает миграцию, а не изменение настройки.
- Throughput persistence. Каждое продвижение исполнения — запись. На стенде под нагрузкой профиля эксплуатации это 46,79 запроса к persistence в секунду при 240 задачах; в проде это первая величина, за которой стоит следить.
- Visibility при больших объёмах. Elasticsearch — отдельная система со своими лимитами; тяжёлые запросы к списку исполнений бьют по ней, а не по persistence.
- Ёмкость воркеров. Самое частое узкое место в реальности — не сервер. Разбор с числами — в статье про эксплуатациюготовится, с 26 октября.
Демо и версии
Стенд: digital-cookbook/architecture/temporal, профиль 01-internals — замер sticky-кэша по метрикам SDK, гашение роли history под нагрузкой, срез persistence.
Топология стенда прод-подобная: PostgreSQL для persistence, Elasticsearch для visibility, четыре роли Temporal раздельными контейнерами. Версии прогона: Temporal Server 1.29.7, PostgreSQL 18.4, Elasticsearch 8.19.5, Go SDK v1.46.0.
Документация и первоисточники
- Канон: Temporal Service — архитектура, Temporal Server, Visibility, Task Queues.
- Исходники: temporalio/temporal (GitHub).
- Смежное на сайте: Temporal — обзор, durable execution — парадигма, детерминизм и replay, WAL и надёжность БД, эксплуатация Temporalготовится, с 26 октября.
Комментарии