
Workflow в Temporal детерминирован и потому бесполезен сам по себе — он не может сходить в сеть или базу. Вся реальная работа живёт в activity. И именно на activity держится надёжность: Temporal ретраит их по политике, следит за таймаутами, умеет возобновлять долгие задачи. Но ровно поэтому activity — то место, где приходится думать про идемпотентность: ретрай вызовет вашу функцию повторно, и если она не идемпотентна, повтор задвоит эффект.
Эта статья разбирает activity как инструмент надёжности — с числами со стенда, включая одно, которое расходится с привычной формулировкой из документации.
В статье
- Почему I/O только в activity
- Четыре таймаута
- Ретраи и что они делают с побочным эффектом
- Идемпотентность: цена отсутствия
- Heartbeat возобновляет не с точки остановки
- Local activity и её цена
Почему I/O только в activity
Тело workflow детерминировано: оно проигрывается заново при каждом восстановлении. Если бы оно ходило в сеть напрямую, каждый повтор дёргал бы внешнюю систему заново.
Activity — обычная функция без ограничений детерминизма. Её вызов и результат попадают в историю: при проигрывании результат берётся из журнала, а сама функция не вызывается. Граница проходит здесь: workflow решает, что делать; activity делает.
Четыре таймаута
| Таймаут | Что ограничивает | Что ловит |
|---|---|---|
| ScheduleToStart | ожидание задачи в очереди до подхвата воркером | нехватку ёмкости воркеров |
| StartToClose | одно выполнение activity | зависание самой работы |
| ScheduleToClose | всё время с учётом ретраев | общий бюджет шага |
| Heartbeat | промежуток между heartbeat долгой activity | зависание внутри долгой работы |
Temporal требует, чтобы был задан хотя бы один из двух: StartToClose или ScheduleToClose. Без них зависшая работа не была бы обнаружена никогда — ретраи по умолчанию бесконечны, и задача осталась бы в состоянии «выполняется» столько, сколько проживёт воркер.
Из двух допустимых полезнее обычно StartToClose, и разница между ними стоит того, чтобы её понимать. ScheduleToClose ограничивает весь шаг целиком, вместе с ретраями: зависшая попытка съест весь бюджет, и следующей уже не будет. StartToClose ограничивает одну попытку, поэтому зависание обнаруживается быстро и ретрай успевает случиться. Практика: задавать StartToClose всегда, а ScheduleToClose добавлять сверху, когда у шага есть осмысленный общий дедлайн.
Для долгих activity StartToClose перестаёт быть детектором зависания: он заведомо велик, потому что работа действительно длинная. Единственный, кто здесь работает, — HeartbeatTimeout: если activity перестала подавать признаки жизни, её попытка считается неудачной, не дожидаясь общего лимита.
ScheduleToStart — единственный из четырёх, который говорит не о самой работе, а о ёмкости. Как он растёт при недонастроенном воркере, разбирается в статье про эксплуатациюготовится, с 26 октября.
Ретраи и что они делают с побочным эффектом
Retry-политика задаёт начальный интервал, коэффициент роста, максимальный интервал и максимум попыток. Разумный дефолт — экспоненциальный backoff; опасен он только в сочетании с отсутствующими таймаутами.
Отдельно стоит помечать ошибки, которые ретраить бессмысленно: ошибка валидации, отказ по бизнес-правилу, ответ внешнего сервиса вида «такого объекта нет» или «доступ запрещён». Иначе Temporal будет добросовестно долбить заведомо безнадёжный вызов, пока не исчерпает бюджет.
Соблазнительное правило «весь класс 4xx — не ретраить» здесь неверно, и ошибка дорогая. 429 Too Many Requests — прямая просьба повторить позже, и не повторять её означает потерять работу на ровном месте; 408 Request Timeout тоже транзиентен. Их надо ретраить, желательно с уважением к заголовку Retry-After. Неретраибельны из 4xx скорее 400, 403, 404, 422 — то есть те, где повтор того же запроса не может дать другого ответа. Критерий не в номере, а в вопросе: может ли тот же вызов позже завершиться иначе.
Но главный вопрос ретраев — не как их настроить, а что происходит с уже сделанной работой.
Идемпотентность: цена отсутствия
Реальный сбой почти никогда не выглядит как «ничего не произошло». Гораздо чаще так: работа выполнена, а подтверждение до вызывающего не дошло. Сеть оборвалась после записи, процесс умер после коммита, таймаут сработал раньше ответа.
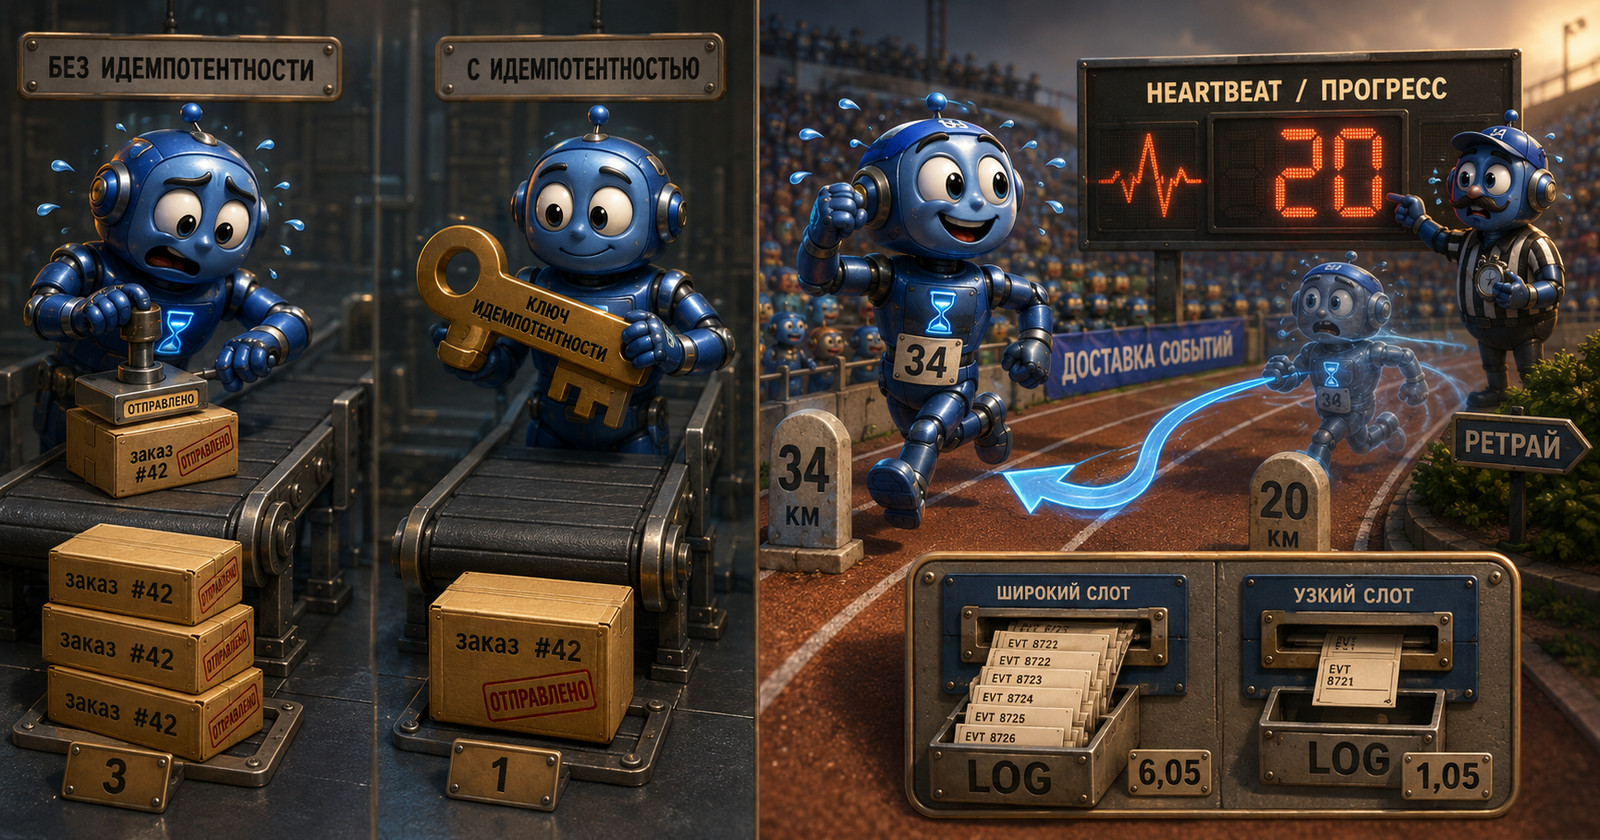
На стенде это воспроизведено буквально: activity пишет строку в таблицу и после записи возвращает ошибку. Две первые попытки падают, третья успешна.
| Activity | Строк эффекта на один логический платёж |
|---|---|
| без ключа идемпотентности | 3 |
| с ключом идемпотентности | 1 |
Три строки — это не «баг Temporal». Это ровно то, о чём договорились: рантайм обещает выполнить шаг хотя бы раз, а не ровно один раз. Сколько раз выполнится ваш побочный эффект — определяется вашим кодом.
Починка в стенде — уникальный индекс по ключу идемпотентности и вставка с игнорированием конфликта. Существенная деталь: ключ выводится из идентификатора работы, а не генерируется внутри activity. Сгенерированный внутри был бы новым на каждой попытке и не защищал бы ни от чего — типичная ошибка, которая выглядит как реализованная идемпотентность.
Это та же связка, что разобрана в статьях про гарантии доставки и идемпотентность и Outbox: «хотя бы раз» плюс дедупликация по ключу даёт наблюдаемое «ровно раз».
Heartbeat возобновляет не с точки остановки
Долгая activity сообщает о прогрессе через heartbeat; при падении воркера новая попытка читает последний heartbeat и продолжает оттуда, а не с нуля. Так это обычно и описывают — «продолжит с последней точки».
Числа со стенда говорят иначе. Импорт из шестидесяти шагов, воркер убивается посередине:
| Величина | Значение |
|---|---|
| Прогресс в таблице к моменту убийства | 34 из 60 |
| Точка, с которой продолжила новая попытка | 20 |
| Итог | 60 из 60 |
Разрыв в четырнадцать шагов — не ошибка стенда. SDK троттлит отправку heartbeat: слать его на каждый шаг было бы дорого, поэтому наружу уходит не каждое значение. Сервер хранит последнее полученное, а оно старше фактического прогресса.
Отсюда точная формулировка, которую стоит держать вместо привычной: heartbeat даёт возобновление примерно оттуда, а не оттуда. Практический вывод жёсткий — шаг долгой activity обязан быть идемпотентным, иначе часть работы выполнится дважды при каждом возобновлении. В нашем случае четырнадцать шагов повторились; таблица это пережила только потому, что запись в ней идёт с обновлением по ключу.
Local activity и её цена
Local activity выполняется прямо в процессе воркера, минуя полный путь через matching. Цена вызова видна в двух измерениях сразу.
| Вид | Время на вызов | Событий истории на вызов |
|---|---|---|
| обычная | 84 314–90 755 мкс | 6,05 |
| local | 428–442 мкс | 1,05 |
Отношение по времени — 192–212×, по событиям истории — 5,76×.
Эти две величины надо читать по-разному, и это важнее самих чисел.
Отношение по событиям истории от машины не зависит, но зависит от устройства workflow. Шесть событий на обычный вызов складываются из двух половин. Три — сама activity: ActivityTaskScheduled, ActivityTaskStarted, ActivityTaskCompleted. Ещё три — workflow task, который будит workflow после её завершения, чтобы код пошёл дальше: WorkflowTaskScheduled, WorkflowTaskStarted, WorkflowTaskCompleted. Local activity выполняется внутри уже идущего workflow task и оставляет в истории одну запись маркера. Величина воспроизвелась до второго знака во всех трёх раундах и на другой машине будет той же — но только для этой схемы: вызовы стенда идут последовательно, и каждая обычная activity порождает свой workflow task. Если запускать несколько activities параллельно, их завершения могут обработаться одним workflow task, и на вызов придётся меньше шести событий; local activity, наоборот, в долгой серии будит workflow task по таймауту. Так что 6,05 против 1,05 — результат для последовательных вызовов, а не константа. Преимущество local activity по объёму истории при этом сохраняется в любой схеме: activity-событий у неё нет вовсе.
Отношение по времени зависит от стенда сильно. В нём сидят сетевые обмены, а на этом хосте каждый из них стоит сотни миллисекунд. На другой машине разрыв будет другим — качественно тот же, количественно нет.
Отсюда и область применения: local activity оправдана для коротких частых вызовов, где накладная полного пути сопоставима с самой работой. Платой становится то, что такая activity не переживает падение воркера как отдельная задача — она часть workflow task, и при потере воркера будет выполнена заново.
Демо и версии
Стенд: digital-cookbook/architecture/temporal, профиль 03-activities — задвоение эффекта при ретрае и его починка ключом, heartbeat с убийством воркера, замер local против обычной activity.
Версии прогона: Temporal Server 1.29.7, PostgreSQL 18.4, Go SDK v1.46.0. Дефолты таймаутов и поведение heartbeat зависят от версии SDK.
Документация и первоисточники
- Канон: Temporal — Activities, Retry Policies, Activity timeouts, Heartbeating.
- Смежное на сайте: Temporal — обзор, детерминизм workflow, гарантии доставки и идемпотентность, Outbox/Inbox, эксплуатация Temporalготовится, с 26 октября.
Комментарии