
«Нужен realtime» почти всегда значит разное. Одному хватит обновления счётчика раз в несколько секунд, другому нужен двусторонний канал, по которому события идут без паузы. Выбор между WebSocket, Server-Sent Events и опросом обычно обсуждают как вопрос вкуса. Здесь он решается счётом: сколько стоит событие на проводе, что с соединением делает прокси, что происходит, когда инстансов больше одного, что теряется при разрыве и что сервер делает с клиентом, который читает медленнее, чем идут события.
Всё это проверено на стенде с двумя серверами — на Go и на Java — с одним и тем же протоколом. Совпадение двух реализаций повышает уверенность, что результат не специфичен для одной из них; доказательством того, что он про транспорт, оно не служит — у реализаций общие предпосылки и похожая прикладная логика. Расхождение — тоже находка, и таких в статье несколько.
Задержек в статье нет ни одной. На ноутбуке с Docker Desktop они меряют ноутбук; вместо них — «дошло или нет», «сколько байт», «сколько потеряно».
В статье
- четыре способа доставки и сколько каждый платит за событие на проводе;
- когда realtime не нужен вовсе и опрос — законный выбор;
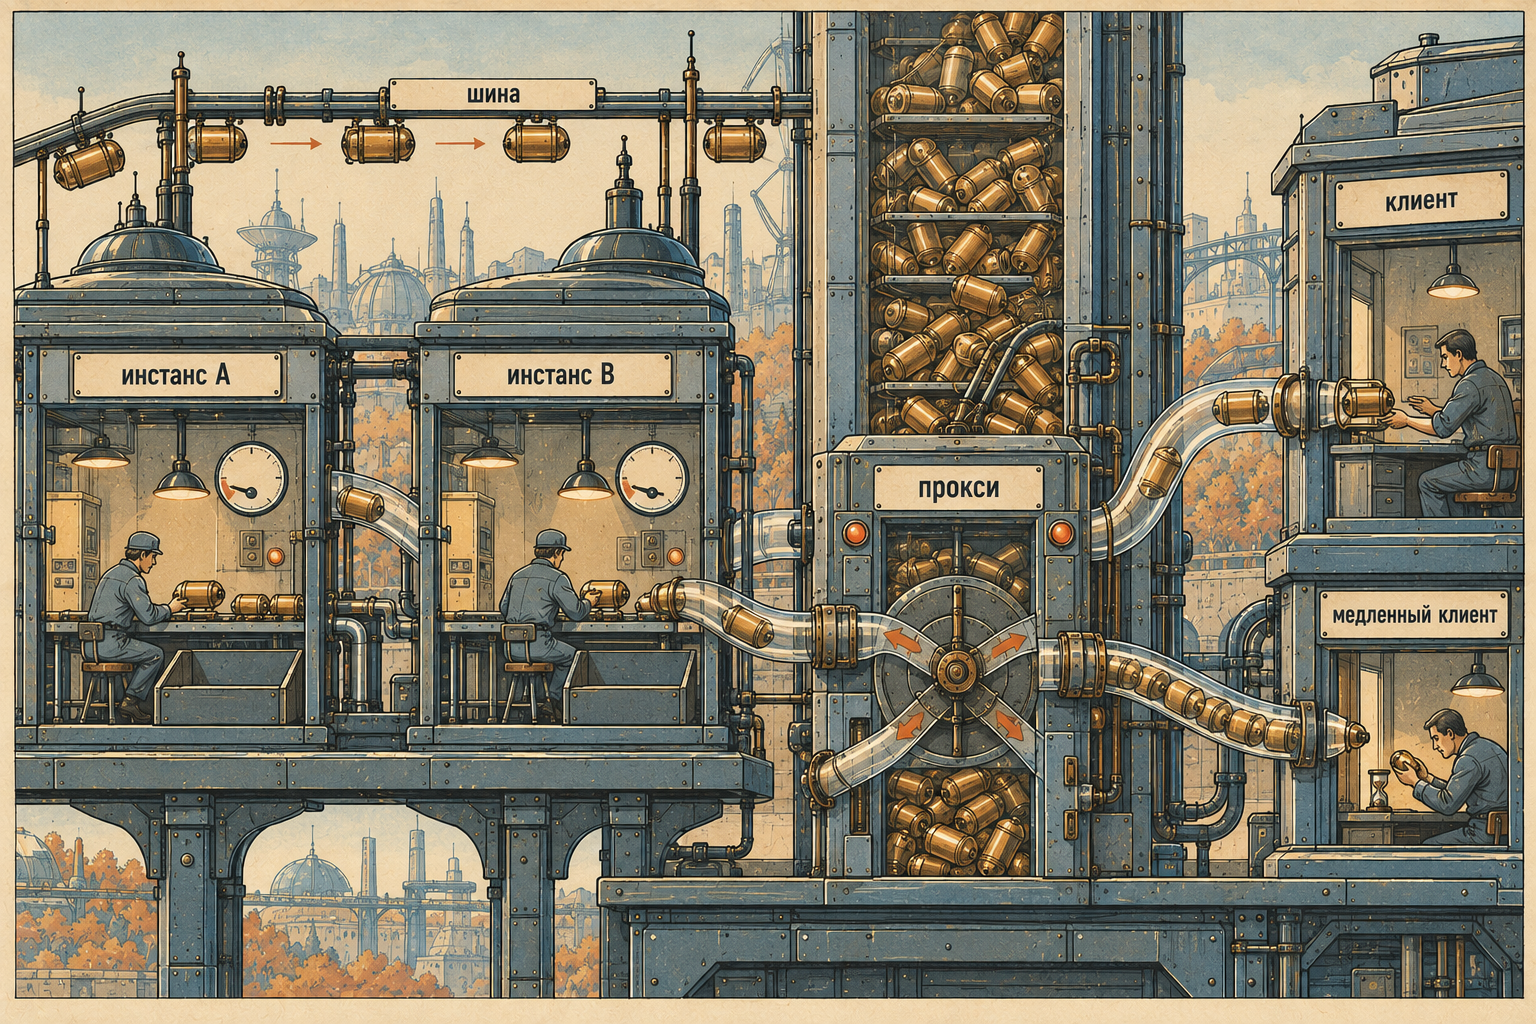
- что делает прокси с длинным соединением и где буферизация на самом деле мешает;
- что меняется, когда инстансов больше одного: шина и привязка клиента;
- что теряется при разрыве и как это догоняют;
- медленный клиент и очередь на сервере;
- сколько памяти стоит простаивающее соединение у Go и Java;
- чего эти числа не значат.
Стенд: два сервера, один протокол
Серверы отвечают на одни и те же маршруты: /sse — поток
text/event-stream, /ws — WebSocket, /poll?after=N — короткий опрос,
/longpoll — длинный, /publish — опубликовать событие. Go-сервер написан на
net/http и coder/websocket, Java-сервер — на Spring Boot 4.1.1 с WebFlux
поверх Netty. Событие — JSON с номером, темой и полезной нагрузкой; номер
задаёт издатель, поэтому пропуски и дубли у клиента видны по номерам.
У номера есть обязательный контракт, без которого догон из раздела про разрывы не работает: номера возрастают в порядке доставки внутри темы. Серверы отбрасывают событие с номером не больше уже отданного, а Redis Streams с явными номерами записей отклоняет запись с меньшим номером (XADD). Уникальности мало: если два издателя независимо выдали 101 и 102, а клиент увидел сначала 102, то 101 потеряется. На стенде издатель один и публикует последовательно. При нескольких издателях курсор должен быть порядком записи в журнал — номером записи в потоке, — а не бизнес-идентификатором, назначенным снаружи.
Что протокол действительно один, проверяет отдельный опыт: одинаковый набор запросов к обоим серверам обязан дать одинаковые наблюдения — коды ответов, заголовки, порядок событий. Он даёт; расхождения, о которых пойдёт речь ниже, появляются только там, где поведение задаёт библиотека.
Между клиентом и сервером — Angie 1.12.2 с отдельным конфигом на каждый
вариант. Шина между инстансами — Redis 8.8 или NATS 2.14. Клиент-проба на Go
реализует используемый стендом поднабор SSE: чтение событий с числовыми
идентификаторами и передачу Last-Event-ID при повторном подключении, — и
умеет считать байты через собственный TCP-прокси. Это не браузерный
EventSource: поле retry проба не обрабатывает, переподключение в опытах она
делает по команде сценария, а не сама.
Четыре способа и цена события
Short polling — клиент спрашивает «что нового» по таймеру. Каждый опрос — полноценный HTTP-запрос и ответ, даже если нового нет.
Long polling — запрос висит на сервере, пока не появится событие или не истечёт срок; получив ответ, клиент сразу задаёт следующий. Это realtime поверх обычного HTTP, но запрос и ответ со всеми заголовками приходятся на каждое событие или пачку событий.
Server-Sent Events — один HTTP-ответ, который не заканчивается: сервер
дописывает в него события в текстовом формате id: … / data: …. Канал
односторонний, от сервера к клиенту, а переподключение с номером последнего
события браузер делает сам
(спецификация).
WebSocket — после HTTP-рукопожатия с Upgrade: websocket соединение
становится двусторонним каналом кадров
(RFC 6455). Заголовок кадра от
сервера — от двух байт.
Постановка. Клиент подключается к серверу через считающий TCP-прокси, издатель публикует мимо прокси, поэтому в счёт идут только байты транспорта клиента. «Байты на проводе» здесь — байты прикладного TCP-потока, HTTP/1.1 без TLS: заголовки TCP/IP, подтверждения и повторные передачи пакетов счётчик не видит. Событие раз в 100 мс, полезная нагрузка 64 байта. Цена события — разностью двух прогонов, на 20 и на 120 событий: рукопожатие и заголовки потока одинаковы в обоих и в разности сокращаются.
| способ | байт от сервера на событие, Go / Java | байт от клиента на событие, Go / Java | запросов на событие, Go / Java |
|---|---|---|---|
| SSE | 132 / 130 | 0 / 0 | 0 / 0 |
| WebSocket | 113 / 113 | 0 / 0 | 0 / 0 |
| long polling | 247 / 211 | 120 / 120 | 1 / 1 |
| опрос раз в 50 мс | 388 / 320 | 226 / 232 | 2,05 / 2,11 |
| опрос раз в 500 мс | 141 / 133 | 23 / 23 | 0,21 / 0,21 |
Контроль сошёлся: все события дошли без дублей в каждом варианте, и ни в одном варианте без сжатия байт на событие не меньше полезной нагрузки.
Само событие в JSON — около 110 байт. WebSocket добавляет к нему только
заголовок кадра, SSE — строки id: и data: и разделители. Разница между ними
— около двадцати байт на событие, и ради неё выбирать транспорт не стоит.
Long polling платит запросом на каждое событие: 120 байт заголовков от клиента и ответ со своими заголовками от сервера. Здесь серверы расходятся: Java отдаёт ответ короче на 36 байт — меньше заголовков. На порядок это не влияет.
Short polling платит не за событие, а за опрос. При опросе раз в 50 мс и событии раз в 100 мс на каждое событие приходится больше двух запросов и около одного пустого ответа. При опросе раз в 500 мс картина обратная: за один ответ приходит пачка из пяти событий, и цена события почти как у SSE. Платят за это задержкой: событие ждёт следующего опроса, до полусекунды. Числа опроса слегка гуляют от прогона к прогону — сколько опросов придётся на прогон, зависит от того, как легли таймеры, — поэтому в сравнение сессий они не входят.
Сжатие зависит от реализации больше, чем от транспорта
Оба транспорта умеют сжимать: SSE — обычным gzip ответа, WebSocket — расширением permessage-deflate (RFC 7692). Gzip потока сжимает его с общим словарём всегда; у permessage-deflate общий словарь между сообщениями — согласуемый параметр (context takeover), и любая сторона может от него отказаться, тогда каждое сообщение сжимается с нуля. На стенде общий словарь согласован в обоих серверах, и повторяющиеся куски JSON у соседних событий должны сжиматься почти в ничто.
| вариант | байт на событие, Go | Java |
|---|---|---|
| SSE без сжатия | 132,4 | 130,4 |
| SSE + gzip | 79,5 | 25,4 |
| SSE + gzip уровня 9 | 25,0 | 25,4 |
| WebSocket без сжатия | 113,2 | 113,2 |
| WebSocket + deflate | 113,2 | 13,5 |
| WebSocket + deflate, порог 1 байт | 71,9 | 13,5 |
У Java сжатие работает, как ожидалось: 25 байт на событие у SSE и 13,5 у WebSocket. У Go — две разные причины плохого результата.
Первая — порог. coder/websocket по умолчанию не сжимает сообщения короче
128 байт при общем словаре — так написано в документации к
CompressionThreshold. Событие стенда короче, и «WebSocket + deflate» у Go
ничем не отличается от варианта без сжатия: расширение согласовано, но не
применяется.
$ python3 scripts/run-wire.py go ws-deflate
{"variant": "go/ws-deflate", "outcome": "delivered", "down_per_event": 113.2, "up_per_event": 0.0, "requests_per_event": 0.0, "empty_per_event": 0.0}
$ python3 scripts/run-wire.py java ws-deflate
{"variant": "java/ws-deflate", "outcome": "delivered", "down_per_event": 13.5, "up_per_event": 0.0, "requests_per_event": 0.0, "empty_per_event": 0.0}
Вторая причина видна, если порог снять: с порогом в 1 байт Go сжимает событие
до 72 байт, а не до 14. Та же картина у gzip потока SSE — 80 байт против 25.
Это свойство compress/flate стандартной библиотеки Go, и стенд проверяет его
отдельной пробой: то же сообщение, сброс сжатия после каждого, три уровня.
$ python3 scripts/run-flate.py
{"kind": "flate", "level": 1, "bytes_per_message": 76.1, "raw": 111, "cmd": "python3 scripts/run-flate.py"}
{"kind": "flate", "level": -1, "bytes_per_message": 76.1, "raw": 111, "cmd": "python3 scripts/run-flate.py"}
{"kind": "flate", "level": 9, "bytes_per_message": 15.2, "raw": 111, "cmd": "python3 scripts/run-flate.py"}
На уровне по умолчанию (-1) и на быстром (1) сжатие при частых сбросах
почти не находит повторов с прошлыми сообщениями — 76 байт из 111. На уровне 9
находит — 15 байт. Go-сервер с gzip уровня 9 даёт ровно то же, что Java: 25
байт на событие. Почему уровни по умолчанию так ведут себя при сбросе после
каждого короткого сообщения — объяснение по коду библиотеки, отдельным замером
оно не проверено; проверено следствие.
Практический вывод: сжатие realtime-потока проверяют замером байт на своём сервере. «Включили deflate» может значить и сокращение в восемь раз, и ровно ничего.
Когда realtime не нужен
Если событие нужно показать «скоро», а не «сразу», опрос — законный выбор. Опрос раз в полминуты стоит один запрос в полминуты на клиента, не держит соединение и проходит через любой прокси и кэш. Насколько он прост дальше, зависит от того, что опрашивают.
Опрос текущего состояния позволяет пропускать промежуточные изменения: клиенту нужно последнее значение, а не история. Ему не нужны ни шина, ни heartbeat, ни догон после разрыва. Так устроена плашка «Доступна новая версия сайта» в истории про VOG: вкладке нужно знать текущую версию, а не каждую выкладку.
Опрос журнала событий — как /poll?after=N на стенде — сохраняет все
требования длинного соединения к истории и восстановлению пропусков. Если
каждое событие нужно доставить, серверу нужен журнал, клиенту — курсор, а
инстансам — общий источник событий, и частота опроса этого не меняет.
Длинное соединение окупается, когда событий много, задержка опроса заметна пользователю или опрос раз в N секунд по тысячам клиентов уже нагружает сервер сильнее, чем открытые соединения. Всё, что дальше, — цена этого выбора.
Прокси между клиентом и сервером
Постановка. Три опыта через Angie, каждый против Go и Java, с контролем без прокси:
- пять событий SSE; сколько клиент получил за 2 секунды, пока поток открыт — счёт до закрытия, иначе прокси отдал бы буфер при закрытии и «доставлено» было бы ложью;
- рукопожатие WebSocket;
- соединение простаивает 6 секунд при
proxy_read_timeout 3s(по умолчанию — 60 секунд, укорочено, чтобы опыт уложился в прогон); затем одно событие.
| опыт | вариант конфига | Go | Java |
|---|---|---|---|
| SSE: событий в окне | без прокси (контроль) | все 5 в окне | все 5 в окне |
| буферизация по умолчанию | все 5 в окне | все 5 в окне | |
| буферизация и gzip | все 5 в окне | все 5 в окне | |
proxy_buffering off |
все 5 в окне | все 5 в окне | |
| рукопожатие WS | без прокси (контроль) | прошло | прошло |
Upgrade и Connection проксируются |
прошло | прошло | |
| не проксируются | отказ, 426 | отказ, 400 | |
| простой WS | без прокси (контроль) | живо | живо |
| таймаут 3 с, без heartbeat | закрыто | закрыто | |
| таймаут 3 с, heartbeat раз в 1 с | живо | живо | |
| простой SSE | без прокси (контроль) | живо | живо |
| таймаут 3 с, без heartbeat | закрыто | закрыто | |
| таймаут 3 с, heartbeat раз в 1 с | живо | живо |
Гипотеза о буферизации не подтвердилась. Записанное до прогона ожидание
было привычным: буферизация ответа в прокси держит события SSE, пока буфер не
наполнится, и proxy_buffering off или заголовок X-Accel-Buffering: no —
обязательная часть настройки. На стенде Angie с буферизацией по умолчанию
доставил все пять событий в окне при открытом потоке — с gzip и без; пробой
при разборе оси то же проверено на nginx 1.27.5. В этом опыте буферизация не
помешала доставить события в окне. Задержку опыт не мерил: он показывает, что
прокси не удержал события до закрытия ответа, но не то, что он отдал их без
добавочной задержки, — и документация nginx одинаковой немедленной доставки с
буферизацией и без неё не обещает. Отдельно обнаружилось другое последствие
буферизации — в разделе про медленного клиента: прокси скрывает его от
сервера.
WebSocket без проксирования заголовков не проходит рукопожатие.
Upgrade и Connection — заголовки «на один пролёт», и прокси их не
передаёт, пока не сказано явно:
location /ws {
    proxy_pass http://backend;
    proxy_http_version 1.1;
    proxy_set_header Upgrade $http_upgrade;
    proxy_set_header Connection $connection_upgrade;  # map: "" → close, иначе upgrade
}
Без двух последних строк сервер получает обычный GET и отказывает. Серверы отказывают по-разному: Go — статусом 426 Upgrade Required, Java — 400. Если в логах клиента одно, а в логах другого сервиса другое, причина одна и та же.
$ python3 scripts/run-proxy.py go handshake no-upgrade
{"variant": "go/handshake/no-upgrade", "outcome": "refused", "detail": "рукопожатие: статус 426"}
Простой дольше таймаута прокси рвёт соединение — и WS, и SSE. Angie
закрывает соединение, по которому сервер ничего не писал дольше
proxy_read_timeout. Для WebSocket это закрытие без кадра закрытия: клиент
видит обрыв TCP, а не код 1000 или 1001, и отличить его от падения сервера по
коду не может.
$ python3 scripts/run-proxy.py go idle ws short-idle
{"variant": "go/idle/ws/short-idle", "outcome": "closed", "detail": "закрыто во время простоя: eof"}
$ python3 scripts/run-proxy.py go idle ws short-idle-hb
{"variant": "go/idle/ws/short-idle-hb", "outcome": "alive", "detail": "после простоя событие дошло"}
Heartbeat чаще таймаута лечит оба транспорта: у WebSocket это кадр ping, у
SSE — строка-комментарий : heartbeat, которую клиент не видит. Интервал
heartbeat выбирают по самому короткому таймауту простоя на пути — прокси,
балансировщика облака, корпоративного прокси клиента, — а не по своему.
Больше одного инстанса
Соединение живёт на одном инстансе, а событие может появиться на любом — там, куда пришёл запрос, который его породил.
Постановка. Два инстанса одного сервера за Angie, клиенты подключаются
через него и расходятся по инстансам; каждый знает свой инстанс по заголовку
X-Instance. Двадцать клиентов SSE или WebSocket, десять событий. Событие
публикуется в один инстанс — как событие, пришедшее обработчику на нём;
дальше его разносит шина или никто.
| шина | Go, SSE | Go, WS | Java, SSE | Java, WS |
|---|---|---|---|---|
| нет | только клиенты инстанса A | только клиенты инстанса A | только клиенты инстанса A | только клиенты инстанса A |
| Redis pub/sub | все 20 | все 20 | все 20 | все 20 |
| NATS | все 20 | все 20 | все 20 | все 20 |
Контроль сошёлся: клиенты в каждом прогоне разошлись по обоим инстансам, и с шиной все клиенты получили все события.
Без шины событие получают ровно клиенты инстанса, в который его опубликовали, а клиенты второго — ни одного. Сколько клиентов окажется на каждом инстансе, зависит от рабочих процессов Angie — у каждого свой счётчик очереди, — поэтому доля от прогона к прогону разная, а сам исход нет. Шина делает из «события на инстансе» событие для всех: каждый инстанс подписан на неё и раздаёт событие своим клиентам. Шина здесь — именно шина: брокер с гарантиями доставки не нужен, нужна рассылка всем подписчикам. Чем различаются брокеры в остальном, разобрано в сравнении RabbitMQ, Kafka, NATS и Redis.
Привязка клиента к инстансу нужна не всем
Sticky sessions часто называют обязательной частью realtime за балансировщиком. Для WebSocket и SSE это не так: соединение одно и уже живёт на одном инстансе, балансировщик его не перекидывает. Привязка нужна, когда состояние клиента лежит в памяти инстанса между запросами — как курсор long polling.
Постановка. Десять клиентов long polling, двадцать событий; курсор —
номер последнего отданного события — сервер хранит в памяти по cookie sid.
Шина Redis, чтобы события были на обоих инстансах и пропуски или дубли шли
только от курсора.
$ python3 scripts/run-scale.py go longpoll scale
{"variant": "go/longpoll/scale", "outcome": "partial", "detail": "пропусков 0, дублей 175; чистых клиентов 0 из 10"}
$ python3 scripts/run-scale.py go longpoll sticky
{"variant": "go/longpoll/sticky", "outcome": "all", "detail": "у всех 10 клиентов ни пропусков, ни дублей"}
Без привязки запросы клиента чередуются между инстансами, и каждый раз клиент
попадает на курсор, отставший на пару событий: дубли у всех десяти клиентов.
С привязкой по hash $cookie_sid consistent — ни одного. У Java то же. Лечит
это и другое решение: курсор присылает сам клиент, как after=N у short
polling, и тогда инстансу помнить нечего.
Разрыв и догон
Длинное соединение рвётся — у клиента меняется сеть, у сервера выкладка, у шины перезапуск. Вопрос не в том, порвётся ли, а в том, что потеряется. Опыты этого раздела рвут соединения при работающем брокере; перезапуск самого брокера — другой случай, о нём ниже.
Разрыв подписки инстанса на шину
Постановка. Между инстансом A и шиной стоит рвущий TCP-прокси пробы; инстанс B публикует в шину напрямую. Пять событий до разрыва, пять во время, пять после восстановления. События разрыва публикуются, только когда A сам сообщил, что подписка порвана, и он сообщает это и после публикации — иначе «потерь нет» могло бы значить «разрыва не было».
| шина | потеряно из 5 событий разрыва, Go | Java |
|---|---|---|
| Redis pub/sub | 5 | 5 |
| Redis Streams | 0 | 0 |
| NATS core | 5 | 5 |
| NATS JetStream | 0 | 0 |
$ python3 scripts/run-reconnect.py go gap redis
{"variant": "go/gap/redis", "outcome": "lost", "detail": "потеряно 5, из них в разрыв 5 из 5"}
$ python3 scripts/run-reconnect.py go gap jetstream
{"variant": "go/gap/jetstream", "outcome": "no-loss", "detail": "все 15 дошли, в том числе 5 из разрыва"}
Pub/sub Redis и core NATS доставляют «не более одного раза»: что опубликовано, пока подписчика нет, ему не достанется никогда. Клиентские библиотеки переподключаются и переподписываются сами, но догнать прошлое им неоткуда. Redis Streams и JetStream — журналы: подписчик помнит последний прочитанный номер и после восстановления дочитывает с него. Как JetStream устроен в остальном, разобрано в статье про JetStream.
Потеря на шине теряет событие сразу для всех клиентов инстанса — тихо: ни клиент, ни сервер ошибки не видят.
Граница результата: проверено восстановление после разрыва подписки при
сохранной истории. Перезапуск брокера опыт не проверяет — и на стенде
JetStream держит поток в памяти (MemoryStorage), такой журнал при
перезапуске сервера NATS пропадает
(документация NATS);
для этого нужен поток в файловом хранилище. Поведение при истёкшей истории
опыт тоже не проверяет.
Клиент возвращается с Last-Event-ID
SSE-клиент после обрыва переподключается сам и присылает номер последнего
события в заголовке Last-Event-ID. Это не гарантия догона, а просьба:
выполнить её сервер может, только если ему есть откуда взять пропущенное.
Постановка. Клиент получает пять событий, рвётся, пока публикуются ещё
пять, возвращается с Last-Event-ID: 5 и ждёт последние пять. Ещё три
варианта проверяют то, что ломается чаще всего.
«Стык» — управляемый барьер между историей и живым потоком: сервер прочитал журнал, сообщил об этом и ждёт; сценарий публикует последние пять событий и только потом отпускает сервер. Прийти к клиенту эти события могут лишь по живой подписке: история уже прочитана без них. Что барьер действительно держал, проверяется по клиенту — к концу публикации у него ничего сверх пяти событий до разрыва. Опыт обязан уметь провалиться, поэтому рядом контроль: та же постановка, но подписка встаёт после чтения истории — неверный порядок, вставленный в сервер нарочно. «Отказ истории»: чтение журнала падает (ошибка тоже вставлена нарочно). У Go и Java одинаково:
| история на сервере | потеряно из 10 событий после разрыва | дублей |
|---|---|---|
| нет | 5 | 0 |
| Redis Streams | 0 | 0 |
| JetStream | 0 | 0 |
| Redis Streams, публикация на барьере | 0 | 0 |
| JetStream, публикация на барьере | 0 | 0 |
| контроль: подписка после истории | 5 | 0 |
| Redis Streams, чтение истории падает | отказ: 503 | 0 |
Без истории заголовок приходит, но сервер ничего не может с ним сделать. С историей — дочитывает из журнала и только потом переходит к живым событиям. На стыке ни пропусков, ни дублей: подписка на живые события встаёт раньше чтения истории, и всё, что пришло за время чтения и ожидания, копится в очереди соединения; повторы, которые есть и в истории, и в очереди, сервер отсекает по номеру — потому номерам и нужен порядок. Контроль с подпиской после истории теряет все пять событий барьера: окно между чтением журнала и подпиской — ровно то место, где теряется событие, если порядок перепутан.
У ранней регистрации подписки есть цена, которую нашла рецензия по коду: подписчик стоит в хабе ещё до того, как начался ответ. Если клиент уходит, пока сервер читает историю, регистрацию надо снять явно — у Java первая версия стенда этого не делала, и опыт это подтвердил: клиент ушёл во время чтения журнала, а в счётчике соединений сервера осталась единица. С явным снятием при отмене запроса — ноль у Go и Java.
Отказ истории — случай, на котором первая версия стенда ошибалась. Go-сервер
игнорировал ошибку чтения журнала и продолжал живой поток: клиент, вернувшийся
с Last-Event-ID: 5, получил бы событие 11 и сдвинул курсор за пропуск, и
следующее переподключение пропуск уже не вернуло бы. Java при той же ошибке
обрывала поток. Ошибку нашла рецензия по коду; теперь оба сервера читают
историю до начала ответа и при ошибке отвечают 503 — клиент знает, что догона
не было, и может повторить позже или запросить полное состояние:
$ python3 scripts/run-reconnect.py go resume redis-streams-history-error
{"variant": "go/resume/redis-streams-history-error", "outcome": "refused", "detail": "догон отказан (503); событий после разрыва дошло: 0"}
Живой поток после неудачного чтения истории нельзя выдавать за успешный догон
— ни при истёкшей истории, ни при временно недоступной. У WebSocket встроенного Last-Event-ID нет — тот же протокол
догона пишут сами.
Ещё один случай — номер старше начала истории: журнал обрезан по сроку или размеру. Сервер стенда тогда молча продолжил бы поток с первого доступного события, и пропуск остался бы незамеченным. Правильнее обнаружить, что история недоступна, и сказать клиенту запросить полное состояние — отдельным событием или кодом ответа, — а не делать вид, что догон удался.
Шторм переподключений
Когда инстанс перезапускается, все его клиенты теряют соединение разом — и разом пытаются вернуться.
Постановка. Двести клиентов WebSocket на одном инстансе, инстанс перезапускается. Пауза перед переподключением — 200 мс плюс случайная добавка до джиттера: 0 или 2000 мс. Счёт — по корзинам в 100 мс от первого разрыва.
$ python3 scripts/run-reconnect.py go storm 0
{"variant": "go/storm/jitter-0ms", "outcome": "burst", "detail": "в худшей корзине 100 мс — 200 переподключений из 200"}
$ python3 scripts/run-reconnect.py go storm 2000
{"variant": "go/storm/jitter-2000ms", "outcome": "spread", "detail": "в худшей корзине 100 мс — 18 из 200, корзин с переподключениями 21"}
Без джиттера все двести клиентов вернулись в одной корзине — в ту же десятую долю секунды, в которую инстанс только поднялся. С джиттером — около двух десятков в худшей корзине у Go и Java. Счёт с джиттером недетерминирован и от прогона к прогону чуть разный; исход — нет. Для двухсот клиентов всплеск безобиден, для двухсот тысяч на инстанс это одновременные рукопожатия, TLS и подписки сразу после рестарта. Экспоненциальная пауза без случайной добавки шторм не рассеивает: все клиенты разорвались одновременно и ждут одинаково.
Медленный клиент
Клиент читает медленнее, чем идут события, — слабая сеть, фоновая вкладка, занятый телефон. Сервер должен решить, что с ним делать: копить, выбрасывать или отключать. Решение и есть политика очереди на соединение.
Постановка. Рядом два клиента одной темы: быстрый и медленный (приёмный буфер 4 КБ, пауза 5 мс после каждого события). Издатель отправляет 3000 событий по 1 КБ подряд — заведомо больше, чем помещается в буферы сокетов, иначе очередь сервера «не росла» бы из-за ядра. Политики очереди при длине 256: без границы, вытеснение старых, отключение медленного. Счёт снимается со стороны сервера.
| транспорт, политика | напрямую | Angie с буферизацией | Angie без буферизации |
|---|---|---|---|
| SSE, без границы | очередь росла | не заметил | очередь росла |
| SSE, вытеснение | выбрасывал | не заметил | выбрасывал |
| SSE, отключение | отключил | не заметил | отключил |
| WS, без границы | очередь росла | очередь росла | очередь росла |
| WS, вытеснение | выбрасывал | выбрасывал | выбрасывал |
| WS, отключение | отключил | отключил | отключил |
Строки одинаковы у Go и Java. Контроль сошёлся: быстрый клиент в каждом варианте получил все события.
Напрямую каждая политика делает своё: очередь без границы растёт до тысяч событий на одно соединение, вытеснение держит её на 256 и выбрасывает старое, отключение рвёт медленного, как только очередь заполнена. Быстрый сосед ничего из этого не замечает.
Какую политику выбрать, решает не механика очереди, а смысл событий. Если событие несёт абсолютное значение — температуру, цену, статус задачи, — потерять промежуточное можно: следующее событие всё равно скажет, что сейчас. Вытеснение для такого потока — честный выбор. Если событие — изменение состояния: «увеличить счётчик», правка документа, новое сообщение в чате, — потерянное событие ломает состояние клиента незаметно для него. Такому потоку нужно либо обнаружение пропуска по номеру и восстановление, либо отключение медленного клиента с последующим догоном из журнала — тем самым, что разобран в разделе про разрывы.
Главная находка оси — SSE через Angie с буферизацией по умолчанию. Сервер медленного клиента не замечает вовсе: очередь не выше трёх событий, и ни одна политика не срабатывает.
$ python3 scripts/run-slow.py go sse disconnect buffered
{"variant": "go/sse/disconnect/buffered", "outcome": "unnoticed", "detail": "сервер не заметил медленного: очередь не выше 2"}
$ python3 scripts/run-slow.py go sse disconnect unbuffered
{"variant": "go/sse/disconnect/unbuffered", "outcome": "disconnected", "detail": "медленный отключён сервером (очередь до 256)"}
С буферизацией прокси читает ответ сервера так быстро, как сервер пишет, и
копит то, что клиент не успел забрать, — в памяти, а сверх буферов во
временном файле; по
документации
до гигабайта на ответ по умолчанию. Для сервера медленного клиента больше
нет: все его политики про медленных клиентов молча выключены, а память и диск
расходует прокси. Это проверенная стендом причина ставить для SSE
proxy_buffering off или X-Accel-Buffering: no: чтобы обратное давление
доходило до сервера.
WebSocket через тот же Angie ведёт себя как напрямую: после рукопожатия прокси пересылает кадры как туннель, и буферизация ответа к нему не применяется.
Сколько стоит простаивающее соединение
Единственная величина в статье, а не исход, — и с оговорками.
Постановка. Сервер без шины; базовый замер памяти — дважды, после
принудительной сборки мусора; затем проба открывает 5000 простаивающих
соединений и держит их; замер — снова после сборки. Память на соединение —
прирост RSS процесса и прирост кучи, делённые на число соединений. Куча у
двух рантаймов меряется разными метриками: у Go — HeapInuse из
runtime.MemStats (память занятых спанов кучи, включая свободное место
внутри них), у Java — MemoryUsage.getUsed() кучи JVM. Это разные величины, и
строку «куча» между Go и Java напрямую не сравнивают. JVM — с фиксированной
кучей 256 МБ.
| Go, WS | Go, SSE | Java, WS | Java, SSE | |
|---|---|---|---|---|
| RSS на соединение, КБ | 32,7 | 34,3 | 12,5 | 27,3 |
| куча на соединение, КБ (Go — HeapInuse, Java — heap used) | 17,4 | 20,7 | 10,1 | 18,6 |
Контроль сошёлся: открыты все 5000 соединений, и два базовых замера расходятся меньше чем на десятую долю прироста.
Числа — одной сессии. Между сессиями у Go они держатся в пределах нескольких процентов, а у Java RSS на WebSocket-соединение гулял заметнее — от 12 до 17 КБ на соединение; поэтому сравнивать здесь стоит порядок, а не десятые доли.
По приросту RSS в этом опыте WebSocket у Java в два с лишним раза дешевле, чем у Go, а SSE у Java примерно вдвое дороже её же WebSocket. Почему — гипотеза по устройству серверов, опыт вклад каждого механизма не выделяет: у Go соединение держат горутины со своими стеками и буферы чтения и записи, Java на Netty держит его без отдельного потока, но с буферами вне кучи; SSE в WebFlux — HTTP-ответ, который не кончается, со своей обвязкой. RSS Java после сборки мусора не возвращает уже занятые страницы кучи, поэтому её прирост RSS — оценка сверху.
Память измерена без gzip и без permessage-deflate. Экономия трафика из
раздела про сжатие с этими числами автоматически не складывается: общий
словарь сжатия хранится на каждое соединение, и
coder/websocket
прямо предупреждает, что context takeover добавляет память на соединение.
Линейная иллюстрация, а не прогноз: сто тысяч таких соединений при тех же приростах заняли бы от 1,2 до 3,4 ГБ — порядок, при котором память на соединение начинает влиять на число инстансов. Под нагрузкой картина другая: очереди медленных клиентов из предыдущего раздела легко стоят больше, чем само соединение. Как устроены пулы исходящих соединений у тех же двух рантаймов, разобрано для Go и JVM.
В браузере
Стенд — серверный, и клиент в нём не браузерный. В веб-приложении к выбору транспорта добавляется несколько вещей, которые стенд не проверял:
- Авторизация. Нативный
EventSourceне умеет добавлять свои заголовки, и браузерный WebSocket API тоже: остаются cookie сессии, токен в адресе (попадает в логи прокси) или авторизация первым сообщением после подключения у WebSocket. - Несколько вкладок. Каждая вкладка открывает своё соединение. По
HTTP/1.1 браузер держит ограниченное число соединений на домен, и
несколько вкладок с SSE могут исчерпать его для всего сайта
(MDN); по
HTTP/2 потоки делят одно соединение. Одно соединение на все вкладки дают
SharedWorkerили выбор ведущей вкладки черезBroadcastChannel. - Переподключение
EventSource. Пока объект в состоянииCONNECTING, переподключением занимается браузер: выдерживает паузу из поляretryи сам присылаетLast-Event-ID. Событиеerrorпри этом тоже приходит — оно сопровождает и штатное переподключение. Финальный ответ после обработки редиректов со статусом, отличным от 200, или с другим типом содержимого браузер считает окончательной ошибкой и переводит объект вCLOSED; ответ 204 — штатный способ сервера остановить переподключения (спецификация). ПересоздаватьEventSourceпослеCLOSEDили нет — политика приложения, и новый объект начинает с пустым номером: накопленный курсор не переносится, а задатьLast-Event-IDнативный конструктор не позволяет. Если нужен догон, приложение само хранит последний номер и передаёт его новым запросом способом, который понимает сервер, — например, параметром адреса. Проба стенда так себя не ведёт: её переподключения задаёт сценарий опыта.
Как выбирать
| нужно | выбор | что настроить сразу |
|---|---|---|
| показать текущее состояние «скоро» | short polling состояния | интервал по допустимой задержке; ни истории, ни шины |
| доставить каждое событие опросом | short polling журнала | after=N от клиента; журнал, общий для инстансов |
| поток событий от сервера | SSE | heartbeat чаще таймаута прокси; proxy_buffering off; история для Last-Event-ID |
| двусторонний обмен | WebSocket | проксирование Upgrade/Connection; ping; свой протокол догона |
| совместимость с чем угодно | long polling | курсор от клиента или sticky |
| больше одного инстанса | любой длинный | шина; журнал вместо pub/sub, если потеря при разрыве недопустима |
| много клиентов | любой длинный | политика медленного клиента; джиттер переподключения |
Для мобильных клиентов к этому добавляются фоновый режим и push-уведомления — отдельная тема серии про бэкенд для мобильныхСкоро.
Чего эти числа не значат
- Ничего о задержке. Окна ожидания — постановка опыта, а не величина.
- Одна машина: macOS arm64, Docker Desktop, сеть — мост Docker без потерь пакетов и без расстояния между узлами. Мобильная сеть рвёт соединения чаще и иначе.
- Версии: Go 1.27.1,
coder/websocket1.8.15, Spring Boot 4.1.1 на Java 21, Angie 1.12.2, Redis 8.8, NATS 2.14. Порог сжатия и уровниcompress/flate— свойства этих версий. - Байт на событие — для события в 64 байта полезной нагрузки. У крупных событий доля заголовков меньше, и разница между транспортами тает.
- Медленный клиент проверен одним темпом чтения и одним размером события; где прокси перестанет копить и начнёт держать сервер, зависит от его буферов и лимита временных файлов.
- Память на соединение — у простаивающего соединения после сборки мусора, у JVM с фиксированной кучей; под нагрузкой и с другими настройками GC картина другая.
- Буферизация не держала события в окне на этих версиях Angie и nginx — это про доставку в окне, задержку опыт не мерил. Другие прокси, CDN и балансировщики облаков могут вести себя иначе — это проверяют своим опытом.
Выводы
- Транспорт стоит выбирать по направлению потока и инфраструктуре, а не по байтам: SSE и WebSocket различаются на два десятка байт на событие.
- Сжатие realtime-потока проверяют замером: у Go оно по умолчанию то не включается для коротких сообщений, то почти не сжимает.
- Heartbeat чаще самого короткого таймаута простоя на пути — обязательная часть любого длинного соединения.
- Буферизация прокси в опыте не помешала доставке SSE в окне, но спрятала от сервера медленного клиента — и с ним все политики обратного давления.
- Больше одного инстанса — нужна шина; pub/sub теряет всё, что пришло во время разрыва подписки, журнал догоняет.
Last-Event-IDработает, только если серверу есть откуда взять историю, номера событий упорядочены, подписка встаёт раньше чтения журнала, а ошибка чтения журнала оборачивается отказом, а не продолжением потока.- Переподключение без случайной добавки к паузе возвращает всех клиентов в одну десятую секунды.
Ссылки
- Стенд: digital-cookbook/architecture/realtime — шесть осей, серверы на Go и Java, конфиги Angie.
- RFC 6455: The WebSocket Protocol
- RFC 7692: Compression Extensions for WebSocket
- HTML Living Standard: Server-sent events
- nginx: ngx_http_proxy_module —
proxy_buffering,proxy_read_timeout,proxy_max_temp_file_size - coder/websocket —
CompressionThreshold

Комментарии