
Большинство сервисов используют gRPC как «REST, только с protobuf»: сгенерировали заготовку, вызвали unary-метод, забыли. Вопросы, которые потом всплывают в эксплуатации, лежат как раз за этим уровнем. Узнает ли нижний сервис, что клиент уже ушёл? Перестанет ли сервер слать стрим, когда его отменили? Какой код увидит клиент, если в обработчике паника? Почему за балансировщиком вся нагрузка легла на один под?
Всё это здесь проверено на стенде, а не пересказано из документации. Один
.proto, сервер и клиент на Go (grpc-go 1.84) и на Java (grpc-java 1.84), и
там, где важна совместимость, — все четыре пары клиент-сервер. Расхождения
между языками — тоже результат, и их в статье несколько.
В статье
- доходит ли срок вызова до нижнего звена цепочки и что его теряет;
- что происходит со стримом после отмены клиентом;
- какой код видит клиент на обычную ошибку,
status, детали и панику; - что gRPC-Gateway делает с кодами и деталями ошибок;
- в каком порядке ставить интерсепторы;
- что делают встроенные ретраи из service config;
- когда keepalive сам рвёт соединение и спасает ли он его за прокси;
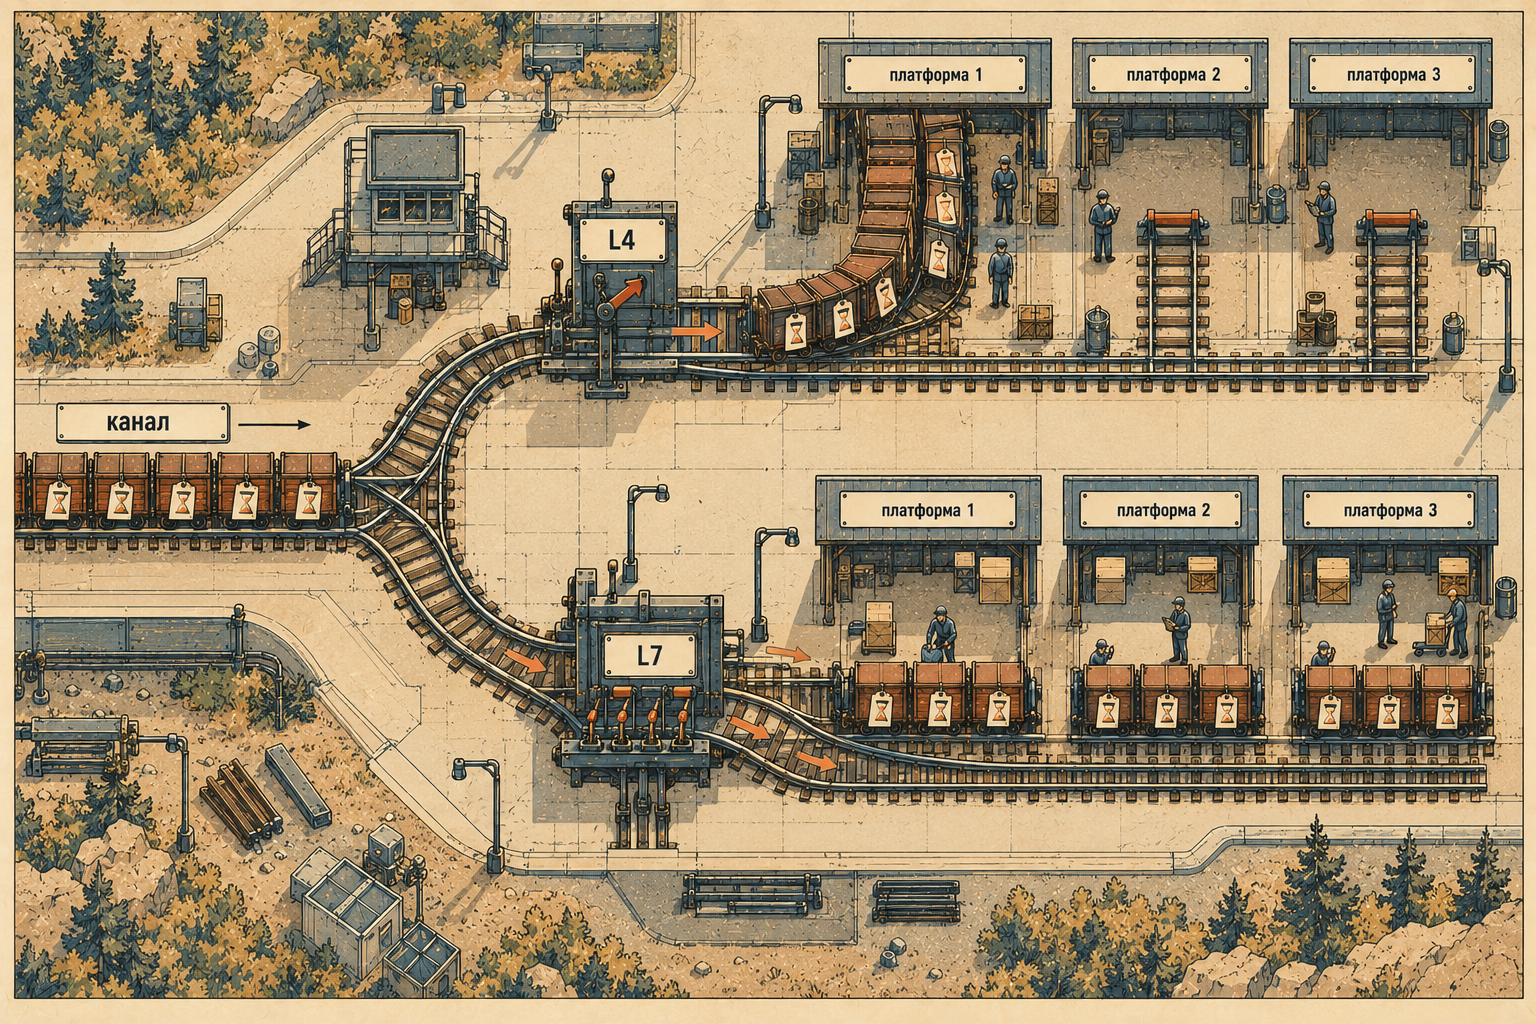
- почему долгое HTTP/2-соединение ломает L4-балансировку;
- чего эти результаты не значат.
Стенд: один контракт, четыре пары
Контракт — пять методов: unary, серверный стрим, клиентский стрим,
двунаправленный стрим и звено цепочки Chain, которое либо работает само, либо
вызывает следующее звено. Поведение сервера для опытов задают поля запроса и
переменные окружения, так что одна сборка ставит все опыты и различие исходов
не может прийти из разных бинарников.
Четыре типа RPC различаются только тем, кто и сколько сообщений шлёт: один запрос — один ответ; один запрос — поток ответов; поток запросов — один ответ; два независимых потока поверх одного HTTP/2-потока. Сгенерированные заготовки у Go и Java выглядят по-разному, но в сети это одни и те же кадры, и контракт одинаково понимают обе стороны.
Что Go и Java ведут себя одинаково по умолчанию, проверяет отдельный опыт: один набор вызовов — все четыре типа RPC и коды ошибок — во всех четырёх парах клиент-сервер обязан дать одинаковые наблюдения. Он даёт. Расхождения, о которых пойдёт речь, появляются там, где поведение задаёт библиотека, а не протокол.
Как устроен сам protobuf и что ломается при эволюции схемы, разобрано в статье про бинарные форматы и статье про эволюцию схемы; здесь — то, что происходит с вызовом.
Deadline: срок вызова и кто о нём узнаёт
gRPC оперирует не таймаутом, а сроком — моментом, после которого результат
никому не нужен. В API вызов ограничен сроком; в заголовке grpc-timeout
библиотека передаёт оставшийся бюджет времени, а не сам момент, — так часы
клиента и сервера не обязаны совпадать. Сервер превращает бюджет снова в срок
в контексте вызова; если он сам вызывает следующий сервис с тем же контекстом,
дальше уходит уже меньший бюджет — потраченное вычтено, — и вся цепочка знает,
когда пора бросать работу.
Постановка. Клиент → звено A → исполнитель B. Срок клиента — 300 мс;
исполнитель работает 10 шагов по 100 мс и перед каждым шагом проверяет отмену.
A вызывает B либо со своим контекстом, либо с новым — в Go
context.Background(), в Java Context.ROOT. Все восемь сочетаний языков
клиента, A и B. Контроль — срок 3 с, больше всей работы.
| клиент → A → B | A передаёт контекст | A создаёт новый |
|---|---|---|
| go → go → go | B бросил работу | B доделал все 10 шагов |
| go → go → java | B бросил работу | B доделал все 10 шагов |
| go → java → go | B бросил работу | B доделал все 10 шагов |
| go → java → java | B бросил работу | B доделал все 10 шагов |
| java → go → go | B бросил работу | B доделал все 10 шагов |
| java → go → java | B бросил работу | B доделал все 10 шагов |
| java → java → go | B бросил работу | B доделал все 10 шагов |
| java → java → java | B бросил работу | B доделал все 10 шагов |
Контроль сошёлся: при сроке больше работы исполнитель доделывает все шаги, и клиент получает OK.
Срок проходит через границу языков в обе стороны: Go-звено передаёт его Java-исполнителю и наоборот, потому что живёт он в заголовке протокола, а не в объекте библиотеки. Теряет его не язык, а одна строка в середине цепочки:
$ python3 scripts/run-deadline.py go java go propagate 300
{"variant": "go->java->go/propagate/300ms", "outcome": "stopped", "client_code": "DeadlineExceeded", "detail": "B узнал об отмене и бросил работу после 3 шагов из 10"}
$ python3 scripts/run-deadline.py go java go fresh 300
{"variant": "go->java->go/fresh/300ms", "outcome": "wasted", "client_code": "DeadlineExceeded", "detail": "B доделал все 10 шагов, об отмене не узнал"}
Клиент получает DEADLINE_EXCEEDED в обоих случаях — у него свой срок. Разница видна только у исполнителя: с новым контекстом он доделывает работу, о которой уже никто не спросит, и держит под ней свои ресурсы. Такую строку легко написать с добрыми намерениями — «пусть запись в базу всё-таки завершится», — и тогда стоит сделать это явно: новый контекст со своим сроком, а не контекст без срока вовсе.
Перед замером стенд делает прогревочный вызов по той же цепочке: без него холодное Java-звено однажды не успело за 300 мс даже позвать B — это сбой постановки, а не свойство gRPC. Сколько шагов исполнитель успевает до отмены, всё равно разнится от прогона к прогону, поэтому публикуется исход — бросил или доделал, — а не число шагов.
Отмена стрима
Отмена — тот же механизм с другой стороны: клиент перестал ждать, и сервер узнаёт об этом из контекста. Узнаёт — но остановится ли, решает код обработчика.
Постановка. Сервер шлёт 20 сообщений с паузой 100 мс; клиент читает 3 и отменяет вызов. Сервер либо проверяет отмену перед каждой отправкой, либо нет. Счёт — на сервере: сколько попыток отправки он сделал после того, как отмена пришла. Контроль — клиент читает все 20 без отмены.
| клиент → сервер | сервер проверяет отмену | не проверяет |
|---|---|---|
| go → go | остановился | цикл до конца, отправка с ошибкой |
| go → java | остановился | цикл до конца, отправка без ошибки |
| java → go | остановился | цикл до конца, отправка с ошибкой |
| java → java | остановился | цикл до конца, отправка без ошибки |
Контроль сошёлся: без отмены клиент получает все 20 сообщений.
Без проверки обработчик доводит цикл до конца в обоих языках — по одной
попытке отправки на каждое оставшееся сообщение. В сеть по отменённому стриму
ничего не уходит, но работа идёт. В Go цикл узнаёт об отмене хотя бы
косвенно: Send после отмены возвращает ошибку, и обработчик, который её
проверяет, выйдет из цикла сам. В Java-сервере стенда onNext после отмены
возвращался молча — но это свойство обработчика, а не библиотеки.
grpc-java различает две вещи: транспорт узнал об отмене и приложению об этом
сообщили. Флаг isCancelled() меняется сразу, его можно опрашивать из любого
потока. Само уведомление — callback onCancel — grpc-java доставляет тем же
последовательным исполнителем, что и вызов обработчика, и пока обработчик не
вернул управление, уведомление ждёт. А исключение CANCELLED из onNext бросается
только после того, как уведомление доставлено, и только если обработчик отмены
(setOnCancelHandler) не установлен
(ServerCallStreamObserver).
В стенде весь цикл отправки шёл внутри обработчика — уведомление до него не
доходило, и исключения не было.
Постановка. Тот же опыт, сервер Java без проверки отмены; цикл отправки идёт либо внутри обработчика вызова, либо в отдельной задаче, запущенной после его возврата; обработчик отмены установлен или нет. Оба клиента.
| где цикл отправки | обработчик отмены | onNext после отмены |
обработчик отмены вызван |
|---|---|---|---|
| внутри обработчика вызова | нет | возвращается молча | — |
| внутри обработчика вызова | есть | возвращается молча | после конца цикла |
| в задаче после возврата | нет | бросает CANCELLED | — |
| в задаче после возврата | есть | возвращается молча | до конца цикла |
Цикл в отдельной задаче получает CANCELLED из onNext на каждой отправке после
отмены — так же косвенно, как Send в Go. С обработчиком отмены исключения нет,
зато вызывается сам обработчик — и вызывается вовремя, только если обработчик
вызова уже вернул управление; внутри него уведомление приходит, когда цикл уже
закончен. Надёжный способ для цикла в обработчике — опрашивать isCancelled()
или контекст: ни исключение, ни callback туда не доберутся. Гипотеза, записанная
до первого прогона, предполагала исключение и в синхронном цикле; стенд показал,
что оно зависит от того, где идёт отправка.
Ошибки: какой код увидит клиент
gRPC передаёт статус вызова — код и сообщение — в трейлерах ответа и позволяет
приложить к нему детали: типизированные сообщения protobuf вроде
google.rpc.ErrorInfo. Код — то, по чему клиент решает, повторять ли вызов и
что показать пользователю, поэтому важно, что именно до него доходит.
Постановка. Обработчик Unary завершается ошибкой одного из видов: обычная
ошибка языка; status с кодом NotFound; тот же status с ErrorInfo в
деталях; паника в Go или исключение в Java — без перехватчика и с ним. После
вызова проверяется, жив ли сервер: и сам контейнер, и отдельный health-вызов.
Все четыре пары; код у клиента не зависит от языка клиента, поэтому в таблице
— по серверу.
| в обработчике | сервер Go | сервер Java |
|---|---|---|
| обычная ошибка языка | Unknown | Unknown |
status с кодом NotFound |
NotFound | NotFound |
то же с ErrorInfo в деталях |
NotFound, детали ErrorInfo |
NotFound, детали ErrorInfo |
| паника (Go) / исключение (Java) | Unavailable, сервер упал | Unknown |
| то же, с перехватчиком | Internal | Internal |
Обычная ошибка языка превращается в UNKNOWN — клиент не может по ней решить
ничего. Это самый частый источник кода UNKNOWN в логах: обработчик вернул
err из нижнего слоя как есть. status с кодом доходит без потерь, детали —
тоже, и клиент на Java разбирает ErrorInfo, отправленный Go-сервером, и
наоборот.
Паника — место, где языки расходятся принципиально:
$ python3 scripts/run-errors.py go go errors panic
{"variant": "go->go/panic", "outcome": "observed", "detail": "код Unavailable; сервер упал"}
$ python3 scripts/run-errors.py go java errors panic
{"variant": "go->java/panic", "outcome": "observed", "detail": "код Unknown; сервер жив"}
Паника в обработчике grpc-go без перехватчика не перехватывается никем и завершает весь процесс: клиент видит UNAVAILABLE, а вместе с ним упали все остальные вызовы, которые сервер в этот момент обслуживал. grpc-java ловит исключение обработчика сама и отвечает UNKNOWN «Application error processing RPC»; сервер живёт. Перехватчик паники для Go — не украшение, а обязательная часть цепочки; с ним оба сервера отвечают INTERNAL. Где именно он стоит в цепочке, тоже важно — об этом в разделе про интерсепторы.
gRPC-Gateway: коды становятся HTTP-статусами
gRPC-Gateway генерирует REST/JSON-фасад из того же .proto — для клиентов без
gRPC: браузера, внешних интеграций, curl. Маршруты здесь заданы отдельным
YAML, а не аннотациями в контракте, — так Java-сборке не нужен googleapis.
Постановка. Тот же сервер (Go и Java) за шлюзом: те же ошибки через REST,
серверный стрим через фасад и срок в заголовке Grpc-Timeout.
| на сервере | ответ шлюза |
|---|---|
| без ошибки | 200 |
| NotFound | 404 (NotFound) |
NotFound с ErrorInfo |
500 (Internal) |
то же, шлюз с импортом errdetails |
404 (NotFound), ErrorInfo в теле |
| InvalidArgument | 400 (InvalidArgument) |
| Unavailable | 503 (Unavailable) |
| обычная ошибка языка | 500 (Unknown) |
| паника с перехватчиком | 500 (Internal) |
| серверный стрим | 200, строк JSON: 3 |
Grpc-Timeout: 300m, работа 1 с |
504 (DeadlineExceeded) |
Шлюз переводит коды в HTTP-статусы по таблице: NotFound — 404, InvalidArgument
— 400, Unavailable — 503, всё необъяснённое — 500. Срок из Grpc-Timeout: 300m
доходит до сервера: исполнитель бросает работу, клиент получает 504. Серверный
стрим приходит строками JSON, по объекту на сообщение.
Главная находка оси — ошибка с деталями:
$ python3 scripts/run-errors.py go gateway details
{"variant": "go/gateway/details", "outcome": "observed", "detail": "HTTP 500 (Internal)"}
$ python3 scripts/run-errors.py go gateway details-registered
{"variant": "go/gateway/details-registered", "outcome": "observed", "detail": "HTTP 404 (NotFound), в теле RECORD_NOT_FOUND"}
Та же ошибка NotFound, но с ErrorInfo в деталях, превращается в 500. Шлюзу
нужно разобрать google.protobuf.Any с деталями, чтобы записать его в JSON, а
для этого тип google.rpc.ErrorInfo должен быть зарегистрирован в его
бинарнике. Сгенерированный код шлюза пакет с этими типами не импортирует; в
журнале шлюза остаётся строка «unable to resolve
type.googleapis.com/google.rpc.ErrorInfo», а клиент получает 500 вместо 404.
Лечится одной строкой — пустым импортом пакета errdetails в main шлюза; с
ней ответ — 404 и ErrorInfo в теле. Ошибка коварна тем, что проявляется
только на ошибках с деталями: всё остальное через шлюз работает.
Интерсепторы: порядок решает, что видно
Интерсепторы — middleware gRPC: функции вокруг обработчика, через которые проходят авторизация, метрики, журнал, трассировка, перехват паники. Они выстраиваются в цепочку, и порядок в ней — не стиль.
Постановка. Три интерсептора — авторизация, метрики, журнал — в двух порядках. Клиент делает 10 вызовов без токена и 10 с токеном. Все пары.
| порядок | метрики видят | журнал видит | до обработчика |
|---|---|---|---|
| авторизация первой | 10 (OK 10) | 10 | 10 |
| метрики первыми | 20 (OK 10, Unauthenticated 10) | 20 | 10 |
Контроль сошёлся: в обоих порядках до обработчика доходят ровно 10 вызовов с токеном.
Если авторизация первой, метрики и журнал не видят ни одного отклонённого вызова: на дашборде нет ни всплеска UNAUTHENTICATED, ни следа подбора токенов. Если метрики первыми, они видят все 20 вызовов и считают отклонённые своим кодом.
С перехватчиком паники порядок ещё строже. Метрики записывают код, когда обработчик вернул управление, а паника этот возврат пропускает. Если перехватчик стоит снаружи метрик, он превращает панику в INTERNAL уже после того, как метрики остались без результата, — клиент видит ошибку, а дашборд нет.
Постановка. Обработчик паникует; перехватчик стоит либо первым в цепочке (снаружи метрик), либо последним, ближе к обработчику. Один вызов с паникой и один без. Все пары.
| перехватчик паники | клиент получил | метрики видят панику |
|---|---|---|
| первым, снаружи метрик | Internal | нет |
| последним, ближе к обработчику | Internal | да, Internal |
Порядок, который видит всё: снаружи — трассировка и метрики, затем журнал,
затем авторизация, и ближе всего к обработчику — перехватчик паники. Тогда
метрики считают и отказы авторизации, и панику, а перехватчик ловит всё, что
бросил обработчик. Тот же порядок рекомендует набор
go-grpc-middleware.
Граница опыта: перехватчик паники стенд проверял только на unary-вызове.
Go-сервер подключает только unary-интерсепторы, и стримы ими не защищены и не
посчитаны — для них нужна отдельная цепочка grpc.ChainStreamInterceptor. В
grpc-java один интерфейс интерсептора служит всем видам вызовов, но что он
поймает, зависит от того, какие callbacks он оборачивает. Перехватчик стенда
оборачивает onHalfClose — в нём grpc-java вызывает обработчик unary- и
серверного стрима. В клиентском и двунаправленном стриме код приложения
получает сообщения через onMessage, и исключение оттуда этот перехватчик не
поймает.
В Go цепочка задаётся списком в порядке вызова. В grpc-java
ServerInterceptors.intercept применяет список так, что последний интерсептор
вызывается первым, — порядок в коде противоположен порядку исполнения, и
Java-сервер стенда строит список наоборот. Ошибку другого рода — код OK в
метриках Java, записанный как «Ok», — поймала проверка, которая требует
одинаковых метрик во всех парах. Как встраивается трассировка OpenTelemetry, разобрано в
статье про инструментирование Go и Java.
Встроенные ретраи
gRPC умеет повторять вызовы сам по политике из service config — без кода в
приложении. Политика называет коды, которые можно повторять, число попыток и
паузы между ними. Сколько попыток доходит до сервера, стенд считает на сервере;
что повторяет именно gRPC, а не проба, видно по заголовку
grpc-previous-rpc-attempts, который библиотека ставит на повторную попытку.
Постановка. Сервер отказывает первым попыткам с заданным кодом. Политика повторяет UNAVAILABLE. Все пары.
| вариант | попыток на сервере | клиент получил |
|---|---|---|
| без политики (контроль), 2 отказа UNAVAILABLE | 1 | Unavailable |
| повтор UNAVAILABLE, maxAttempts 4, 2 отказа | 3 | OK |
| та же политика, 2 отказа INTERNAL | 1 | Internal |
| maxAttempts 10, 7 отказов UNAVAILABLE | 5 | Unavailable |
| maxAttempts 4, пауза около 1 с, срок 500 мс | 1 | DeadlineExceeded |
| стрим без политики (контроль), отказ без заголовков ответа | 1 | Unavailable, сообщений 0 |
| стрим, повтор UNAVAILABLE, отказ без заголовков ответа | 4 | Unavailable, сообщений 0 |
| стрим, повтор UNAVAILABLE, заголовки ответа, затем отказ | 1 | Unavailable, сообщений 0 |
| стрим, повтор UNAVAILABLE, отказ после первого сообщения | 1 | Unavailable, сообщений 1 |
Контроль сошёлся: без политики — одна попытка.
Повторяются только коды из retryableStatusCodes: INTERNAL проходит к клиенту
с первой попытки, как и должно, — повторять ошибку логики бессмысленно.
maxAttempts: 10 библиотеки молча урезают до 5:
$ python3 scripts/run-retry.py java java max10
{"variant": "java->java/max10", "outcome": "observed", "detail": "попыток на сервере 5, клиент получил Unavailable"}
Пять попыток вместе с первой, то есть не больше четырёх повторов, — предел по
умолчанию: в grpc-go его задаёт WithMaxCallAttempts, и политика из service
config выше него не поднимается.
Срок вызова ограничивает и повторы. Пауза перед повтором в grpc-go и grpc-java
1.84 — initialBackoff с разбросом ±20%: при initialBackoff 1 с первая пауза
от 0,8 до 1,2 с, длиннее срока 500 мс, и вторая попытка не успевает никогда —
клиент получает DEADLINE_EXCEEDED после первой.
Совпадение кода с retryableStatusCodes ещё не означает повтор. Как только
клиент получил от сервера заголовки ответа, вызов считается зафиксированным, и
библиотека его больше не повторяет
(правила повторов). Стенд проверяет эту
границу на серверном стриме (строки «стрим» в таблице). Сервер отвечает
UNAVAILABLE сразу, без заголовков, — стрим повторяется, как unary-вызов. Сервер
отправляет заголовки ответа и только потом UNAVAILABLE, не отправив ни одного
сообщения, — повтора уже нет: на сервере один вызов, у клиента ноль сообщений.
Значит, фиксирует вызов именно заголовок, а не первое сообщение. Отказ после
первого сообщения — тот же случай: заголовки ушли вместе с ним. Есть и случай,
который стенд не ставил: прозрачные повторы — когда запрос не дошёл до
обработчика сервера, библиотека повторяет его сама, без всякой политики. Когда повторять безопасно, как ограничивать повторы
бюджетом и что такое retry throttling, разобрано в
статье про resilience-паттерны.
Соединение: keepalive, прокси и балансировка
Слишком частые пинги
Keepalive gRPC — кадры PING HTTP/2: клиент проверяет, жив ли пир, и не даёт
промежуточным узлам счесть соединение простаивающим. Сервер, в свою очередь,
защищается от слишком частых пингов: по умолчанию в обеих библиотеках он
разрешает их не чаще раза в 5 минут, а за повторные нарушения отвечает GOAWAY
с кодом ENHANCE_YOUR_CALM и пометкой too_many_pings.
Постановка. Клиент пингует раз в 10 секунд — чаще клиенты Go и Java не позволяют, меньшие значения поднимают до 10 с. Долгий серверный стрим, который молчит: одно сообщение в начале и одно через 50 секунд. Политика сервера — по умолчанию или с разрешённым интервалом в 5 секунд.
| политика сервера | клиент Go | клиент Java |
|---|---|---|
| по умолчанию (не чаще раза в 5 минут) | GOAWAY, Unavailable | GOAWAY, ResourceExhausted |
| разрешено раз в 5 с | стрим дожил | стрим дожил |
Политика по умолчанию обрывает стрим. Код, который видит клиент, зависит от языка клиента, а не сервера: grpc-go называет обрыв UNAVAILABLE, grpc-java — RESOURCE_EXHAUSTED. Первая постановка опыта — стрим с сообщением каждую секунду — GOAWAY не получала вовсе: сервер прощает пинги, пока сам пишет в соединение. Под удар попадают как раз долгие тихие стримы — подписки и уведомления, ради которых keepalive и включают. Пинги клиента согласуют с политикой сервера, а не выбирают в одиночку.
Простой за прокси
Постановка. Вызов, простой 20 секунд, вызов; таймаут простоя у прокси — 15 секунд. Пути: напрямую (контроль), Angie и Envoy как L4 и как L7. Пинги: выключены или раз в 10 секунд, и сервер их разрешает. Пережило ли соединение простой, проба решает по локальному адресу TCP-соединения клиента с прокси: у обоих вызовов он один — соединение то же, разный — открыто новое. Состояние канала перед вторым вызовом записано рядом, но доказательством не служит: канал мог переподключиться и снова стать READY (состояния канала).
| путь | без пингов | пинги раз в 10 с |
|---|---|---|
| напрямую (контроль) | пережило | пережило |
| Angie, L4 (stream) | закрыто, новое соединение | пережило |
| Envoy, L4 (tcp_proxy) | закрыто, новое соединение | пережило |
| Angie, L7 (grpc_pass) | закрыто, новое соединение | закрыто, новое соединение |
| Envoy, L7 (HTTP) | закрыто, новое соединение | закрыто, новое соединение |
Контроль сошёлся: без прокси соединение переживает простой.
Второй вызов проходит во всех случаях — клиент переподключается сам. Разница в
том, пережило ли соединение простой. За L4-прокси пинги клиента — обычный
трафик, и они продлевают соединение. За L7 — нет: и у Angie grpc_pass, и у
Envoy HTTP таймаут простоя соединения считает активные вызовы, а не байты, и
PING-кадры его не сбрасывают.
$ python3 scripts/run-keepalive.py go idle angie-l4 on
{"variant": "go/idle/angie-l4/ka-on", "outcome": "survived", "detail": "соединение пережило простой: оба вызова по одному соединению (канал READY)"}
$ python3 scripts/run-keepalive.py go idle envoy-l7 on
{"variant": "go/idle/envoy-l7/ka-on", "outcome": "reconnected", "detail": "соединение закрыто на простое, второй вызов — по новому (канал перед ним IDLE)"}
Это опыт про соединение без вызовов, и переподключение для следующего
unary-вызова почти незаметно. Открытый стрим — уже активный вызов, и к нему
таймаут простоя соединения не применяется; молчание внутри вызова ограничивают
другие параметры — у Angie grpc_read_timeout (60 с по умолчанию), у Envoy
stream_idle_timeout (5 минут), — а L4-прокси видит только тишину в TCP и о
вызовах не знает вовсе
(таймауты Envoy).
Постановка. Активный серверный стрим молчит 20 секунд — сообщение в начале и через 20 секунд — при том же таймауте простоя 15 секунд. Пути и пинги — те же.
| путь | стрим без пингов | стрим с пингами раз в 10 с |
|---|---|---|
| напрямую (контроль) | дожил | дожил |
| Angie, L4 (stream) | оборван | дожил |
| Envoy, L4 (tcp_proxy) | оборван | дожил |
| Angie, L7 (grpc_pass) | дожил | дожил |
| Envoy, L7 (HTTP) | дожил | дожил |
За L7 молчащий стрим доживает и без пингов: у открытого вызова свои, более длинные таймауты. За L4 без пингов он обрывается на 15 секундах тишины, с пингами — доживает. Получается зеркально: пинги клиента нужны за L4, чтобы дожил молчащий стрим, и бесполезны за L7, где соединение без вызовов закроют всё равно. Таймауты прокси настраивают по двум вопросам отдельно — сколько держать соединение без вызовов и сколько терпеть молчание внутри вызова.
Балансировка долгого соединения
Канал gRPC мультиплексирует вызовы поверх HTTP/2-соединений, и сколько у него
соединений, решают адрес и политика балансировки: с pick_first — одно, с
round_robin — по соединению на каждый адрес, который вернул резолвер. Когда
перед сервисом один адрес балансировщика, соединение тоже одно, и для
балансировщика, который распределяет соединения, это одна единица работы,
сколько бы вызовов в ней ни шло.
Постановка. Три бэкенда; клиент делает 30 вызовов по одному каналу. Пути:
напрямую по DNS-имени с политикой pick_first (контроль) и round_robin;
Angie и Envoy как L4 и как L7. Все пары; счёт — какой бэкенд ответил и сколько
соединений каждый принял.
| путь | куда ушли 30 вызовов |
|---|---|
напрямую, pick_first (контроль) |
все на один бэкенд |
напрямую, round_robin по DNS |
на все три |
| Angie, L4 (stream) | все на один бэкенд |
| Envoy, L4 (tcp_proxy) | все на один бэкенд |
| Angie, L7 (grpc_pass) | на все три |
| Envoy, L7 (HTTP) | на все три |
$ python3 scripts/run-balance.py go go angie-l4
{"variant": "go->go/angie-l4", "outcome": "pinned", "detail": "все 30 вызовов на одном бэкенде"}
$ python3 scripts/run-balance.py go go angie-l7
{"variant": "go->go/angie-l7", "outcome": "spread", "detail": "вызовы по бэкендам: 10, 10, 10"}
L4-балансировщик выбрал бэкенд один раз — при установке соединения, — и все
30 вызовов ушли на него; два других простаивают. Это классическая картина
«после выкладки вся нагрузка на одном поде»: Kubernetes Service без меша — тот
же L4. Помогают L7-прокси, который разбирает HTTP/2 и выбирает бэкенд на каждый
вызов, или клиентская балансировка: round_robin по DNS-имени, за которым все
адреса бэкендов, открывает по соединению на каждый и раздаёт вызовы по кругу.
В Kubernetes для этого нужен headless Service: обычный Service отвечает на DNS
одним адресом ClusterIP, и round_robin поверх него балансирует по одному
адресу, то есть никак; headless Service возвращает адреса подов
(DNS для сервисов).
Как пулом соединений управляет сам клиент, разобрано в
статье про Go-клиент под нагрузкой.
Размер сообщения
Предел принимаемого сообщения по умолчанию — 4 МБ у обоих клиентов. Ответ в 5 МБ клиент отклоняет кодом RESOURCE_EXHAUSTED — сервер его честно отправил, и ошибка видна только у получателя; с поднятым пределом ответ доходит. Большие данные в gRPC отдают стримом частями, а не поднимают предел до размера самого большого ответа.
Как выбирать настройки
| что | на стенде | что делать |
|---|---|---|
| срок вызова | теряется на звене с новым контекстом | передавать контекст дальше; новый — только со своим сроком |
| отмена стрима | без проверки цикл идёт до конца; в Java уведомление об отмене ждёт возврата обработчика | проверять отмену в цикле: в Go — контекст, в Java — isCancelled() |
| ошибки | обычная ошибка — UNKNOWN | возвращать status с кодом; детали — ErrorInfo |
| паника | Go без перехватчика падает целиком; перехватчик снаружи метрик прячет панику от них | перехватчик паники ближе всего к обработчику; для стримов — своя цепочка |
| шлюз | детали ошибки — 500 | пустой импорт errdetails в шлюзе |
| интерсепторы | метрики после авторизации слепы к отказам | метрики и журнал снаружи, авторизация внутри |
| ретраи | только retryableStatusCodes, по умолчанию не больше 5 попыток вместе с первой, не после заголовков ответа |
повторять только идемпотентное, по UNAVAILABLE |
| keepalive | пинги чаще политики сервера — GOAWAY на тихом стриме | согласовать интервал клиента с MinTime / permitKeepAliveTime |
| простой соединения за L7 | пинги не спасают, следующий вызов переподключается | таймаут без вызовов — по цене переподключения |
| молчание стрима за L4 | без пингов обрыв | пинги клиента чаще таймаута L4, согласованные с сервером |
| балансировка | L4 сажает соединение на один бэкенд | L7-прокси или клиентский round_robin по headless Service |
Чего эти результаты не значат
- Ничего о задержке и пропускной способности. Сроки и паузы — постановка.
- Одна машина: macOS arm64, Docker Desktop, сеть — мост Docker.
- Версии: grpc-go и grpc-java 1.84, protoc 36.2, grpc-gateway 2.31, Angie
1.12.2, Envoy 1.39. Минимальный интервал пингов, предел
maxAttemptsи отображение кодов в HTTP — свойства этих версий. - Прокси — в конфигурации стенда с таймаутами простоя 15 с. У балансировщиков облаков и сервис-мешей свои таймауты и своя реакция на пинги — это проверяют своим опытом.
- Ретраи — по одному вызову на ключ. Под нагрузкой повторы ещё и ограничиваются retry throttling, который стенд не включал; прозрачные повторы стенд не ставил.
- Flow control не разобран. Что делает отправитель, когда получатель стрима читает медленно, и как в двунаправленном стриме это доводит до взаимной блокировки, — отдельный опыт, которого здесь нет (flow control).
Выводы
- Срок вызова доходит до нижнего звена через любые языки, если его не потерять в середине новым контекстом.
- Отменённый стрим останавливает только проверка в обработчике. В Java
исключение и callback отмены доходят лишь до кода, который работает после
возврата обработчика; цикл внутри обработчика опрашивает
isCancelled(). - Обычная ошибка — UNKNOWN; код ставят явно. Перехватчик паники в Go обязателен.
- gRPC-Gateway без зарегистрированных типов деталей превращает ошибки с деталями в 500.
- Порядок интерсепторов решает, что видят метрики: перехватчик паники — ближе к обработчику, иначе паника проходит мимо них.
- Встроенные ретраи повторяют только названные коды, в пределах настроенного числа попыток (на стенде предел по умолчанию — пять вместе с первой) и прекращаются, как только пришли заголовки ответа.
- Keepalive клиента согласуют с политикой сервера; он держит молчащий стрим за L4-прокси и не держит соединение без вызовов за L7.
- За L4-балансировщиком соединение канала — один бэкенд.
Ссылки
- Стенд: digital-cookbook/architecture/grpc — девять осей, Go и Java, конфиги Angie и Envoy.
- gRPC: Deadlines
- gRPC: Error handling
- gRPC: Keepalive
- gRPC: Retry
- gRPC-Gateway
Обсуждение в Telegram
Присоединиться →