
Проектор из практической статьи — это правильный каркас: читать по глобальной позиции, применять идемпотентно, сохранять чекпоинт. Вопрос, который каркас не закрывает — что именно происходит, когда проектор падает не на границе пачки, а посреди неё, и как убедиться, что после рестарта проекция действительно совпала с историей, а не просто выглядит правдоподобно. Эта статья разбирает две вещи ниже уровня каркаса: атомарность «применил плюс сдвинул чекпоинт» на конкретном коде и сверку, которая обязана уметь падать — потому что сверка, которая падать не умеет, ничего не проверяет.
Третья статья серии. Опирается на event store вглубь (глобальная позиция, PRIMARY KEY (stream_id, version)) и на проектирование агрегатов (события-факты, Apply); мостик к гарантиям доставки и идемпотентности и к CQRS на практике (read-сторона).
В статье
- Чекпоинт и применение в одной транзакции
- BIGSERIAL — не порядок коммитов, и это теряет события
- Обрыв на середине и рестарт: числа
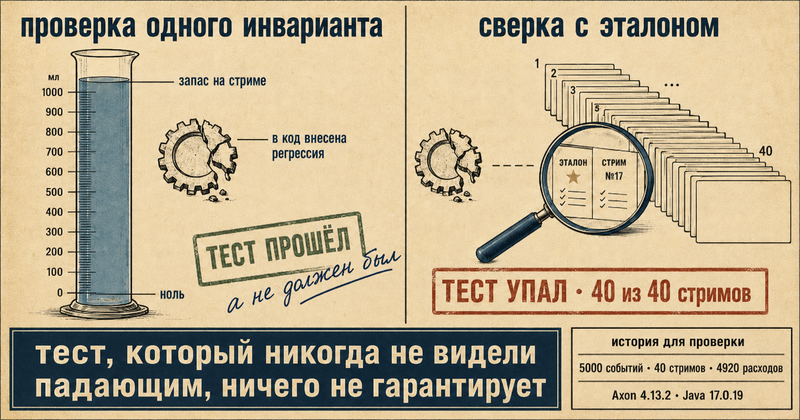
- Сверка, которая не могла провалиться
- Второй слепой случай: неизвестный тип события
- Идемпотентность: guard есть, а повтора нет
- Пересборка без остановки чтения
- Граница вывода
Чекпоинт и применение в одной транзакции
Правило звучит очевидно, пока не попробуешь его нарушить: применение событий пачки и сдвиг чекпоинта обязаны попасть в одну транзакцию. Сделать их порознь — прочитать пачку, применить в balances, зафиксировать, отдельным запросом сдвинуть checkpoints.global_pos — значит оставить окно между двумя коммитами. Упади процесс в этом окне, при рестарте чекпоинт всё ещё указывает на старую позицию, а balances уже содержит применённую пачку: следующий запуск честно перечитает диапазон global_pos > checkpoint и применит те же события второй раз.
ProjectBatch стенда закрывает это одной транзакцией на всю пачку — чтение чекпоинта, SELECT событий, применение каждого и обновление checkpoints идут через один pgx.Tx, коммитятся или откатываются вместе:
func ProjectBatch(ctx context.Context, pool *pgxpool.Pool, projector string, limit int) (int, error) {
	tx, err := pool.Begin(ctx)
	if err != nil {
		return 0, err
	}
	defer func() { _ = tx.Rollback(ctx) }()

	// Водяной знак — ПЕРВЫМ запросом, до любой записи. Зачем он вообще
	// нужен, разбирает следующий раздел.
	var watermark string
	if err := tx.QueryRow(ctx,
		`SELECT pg_snapshot_xmin(pg_current_snapshot())::text`).Scan(&watermark); err != nil {
		return 0, err
	}

	var pos int64
	var curXid string
	// DO UPDATE SET projector = EXCLUDED.projector выглядит пустой операцией
	// (столбец переписывается тем же значением, которое уже там лежит), но
	// присваивание — предлог: DO UPDATE берёт блокировку строки чекпоинта на
	// время транзакции, чего DO NOTHING не сделал бы.
	if err := tx.QueryRow(ctx,
		`INSERT INTO checkpoints (projector, global_pos, xid) VALUES ($1, 0, '0'::xid8)
		 ON CONFLICT (projector) DO UPDATE SET projector = EXCLUDED.projector
		 RETURNING global_pos, xid::text`, projector).Scan(&pos, &curXid); err != nil {
		return 0, err
	}

	// Курсор — ПАРА (xid, global_pos), и читаются только события завершённых
	// транзакций: xid < водяного знака. Псевдоним xid_text обязателен: без
	// него ORDER BY xid сортировал бы по текстовому выходному столбцу.
	rows, err := tx.Query(ctx,
		`SELECT global_pos, stream_id, version, data, xid::text AS xid_text FROM events
		 WHERE (xid > $1::xid8 OR (xid = $1::xid8 AND global_pos > $2))
		   AND xid < $3::xid8
		 ORDER BY events.xid, events.global_pos LIMIT $4`, curXid, pos, watermark, limit)
	// ... сканирование в batch опущено ...

	for _, r := range batch {
		// delta — знаковая величина события (см. Apply во второй статье
		// серии: +liters на OxygenAdded, -liters на OxygenConsumed),
		// вычисляется в опущенном фрагменте сканирования batch выше.
		//
		// Guard version = $2 - 1 делает применение идемпотентным:
		// повторное событие той же версии не изменит строку. Разбор случаев,
		// когда UPDATE не задел ни одной строки, опущен — он в разделе про
		// идемпотентность.
		if _, err := tx.Exec(ctx,
			`UPDATE balances SET liters = liters + $3, version = $2
			 WHERE stream_id = $1 AND version = $2 - 1`,
			r.stream, r.version, delta); err != nil {
			return 0, err
		}
		pos, curXid = r.pos, r.xid
	}

	if _, err := tx.Exec(ctx,
		`UPDATE checkpoints SET global_pos = $2, xid = $3::xid8 WHERE projector = $1`,
		projector, pos, curXid); err != nil {
		return 0, err
	}
	return len(batch), tx.Commit(ctx)
}
Псевдоним xid_text в запросе пачки — не украшение, а защита от ловушки, в которую легко попасть. Без него выходной столбец xid::text называется xid, и ORDER BY xid по правилам SQL сортирует по этому текстовому столбцу, а не по events.xid типа xid8: пачка идёт в порядке «1000, 10000, 10001, …, 762», чекпоинт берёт xid последней строки, и проектор падает на разрыве версий или перешагивает события. Пока все xid одной длины, текстовый порядок совпадает с числовым, поэтому на долгоживущей базе ошибка не видна. На свежей базе она проявляется сразу, а в рабочей системе — на переходе через 999 999. В стенде есть контрпример с xid 9, 10 и 100: запрос без псевдонима на нём падает, запрос с псевдонимом применяет стрим по порядку.
Три детали важны для дальнейшего разбора. Во-первых, чекпоинт читается тем же tx.QueryRow внутри транзакции, а не снаружи — границы диапазона фиксируются один раз и не расползаются. Во-вторых, UPDATE checkpoints идёт последней строкой перед tx.Commit — если применение любого события пачки упадёт, defer tx.Rollback откатит и уже изменённые строки balances, и (несостоявшийся) сдвиг чекпоинта. В-третьих, guard version = $2 - 1 — к нему статья вернётся отдельно в разделе про идемпотентность.
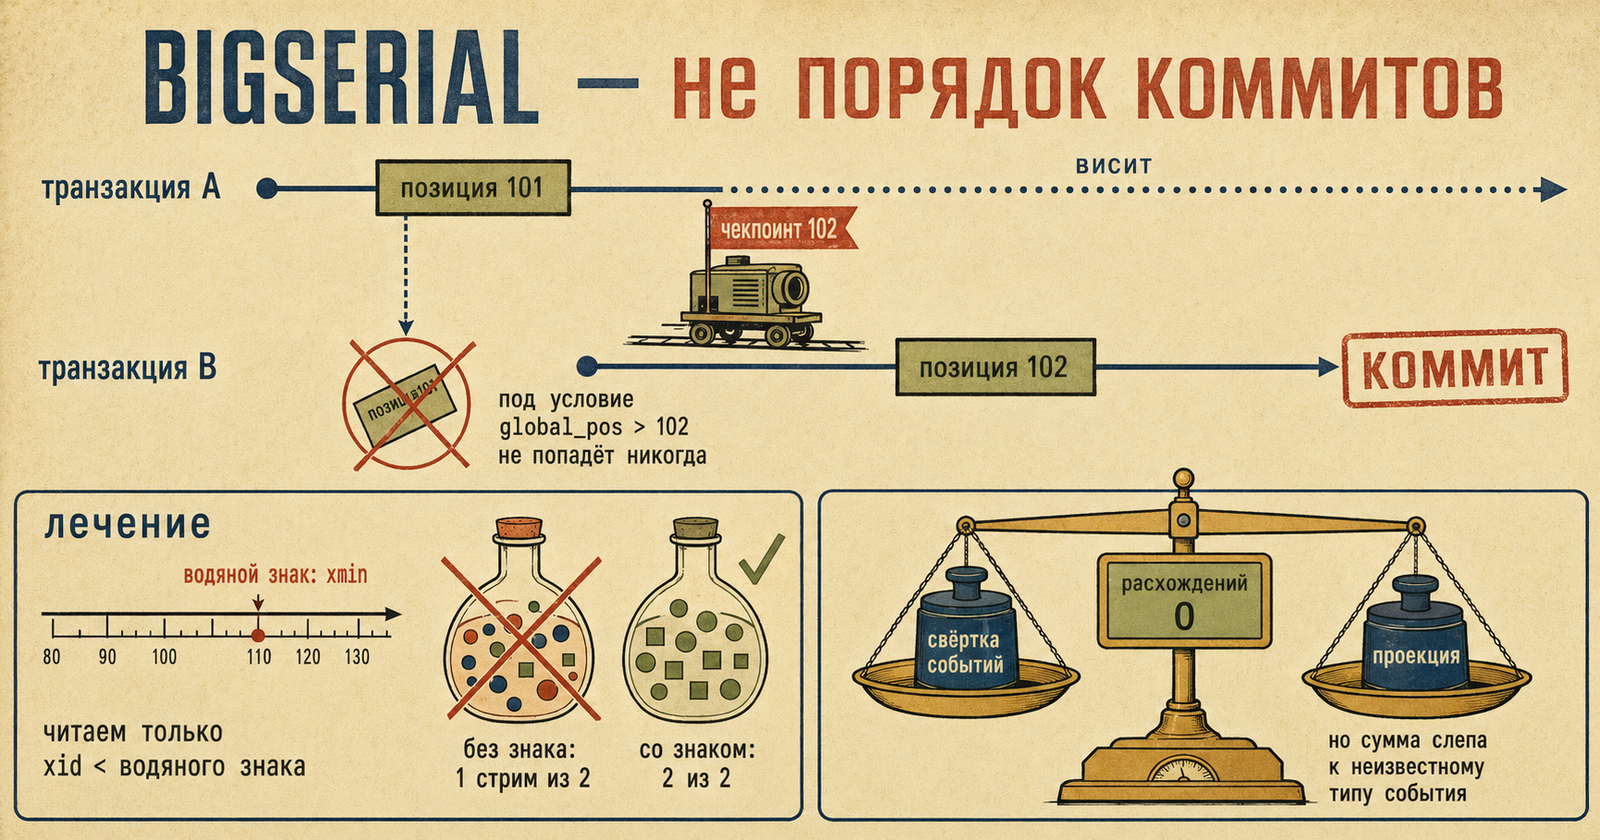
BIGSERIAL — не порядок коммитов, и это теряет события
Курсор выше устроен сложнее, чем требует здравый смысл: пара (xid, global_pos) вместо одного числа плюс какой-то водяной знак. Разберём, почему простой вариант — WHERE global_pos > checkpoint ORDER BY global_pos — неверен. Это не теоретическая придирка: именно так написано в большинстве руководств по event sourcing поверх Postgres, и такой курсор легко написать, не заметив дефекта.
BIGSERIAL задаёт порядок выдачи номеров, а не порядок коммитов. Значение берётся из сиквенса в момент INSERT; видимым для читателей событие становится в момент COMMIT. Между этими моментами может пройти сколько угодно времени — длинная транзакция, ожидание блокировки, медленная сеть до клиента, который ещё не прислал COMMIT. Отсюда сценарий:
- транзакция A вставляет событие, получает
global_pos = 1и задерживается, не коммитясь; - транзакция B вставляет событие, получает
global_pos = 2и коммитится сразу; - проектор просыпается. Событие A он не видит — оно не закоммичено. Событие B видит, применяет, ставит чекпоинт на 2;
- транзакция A коммитится. Её событие с позицией 1 теперь видимо — но под условие
global_pos > 2не попадает и не попадёт уже никогда.
Событие потеряно. Не «применено дважды», не «применено с задержкой» — потеряно навсегда, без ошибки, без исключения, без расхождения счётчиков. Атомарность применения и чекпоинта, которой посвящён предыдущий раздел, здесь не помогает совершенно: транзакция проектора отработала идеально корректно, просто в диапазоне, из которого событие выпало.
Стенд воспроизводит это буквально — транзакция A держится открытой pg_sleep, пока B коммитится и проектор отрабатывает:
позиции в events (A ещё не закоммичена, её строки не видно):
     stream_id | global_pos |   xid
    -----------+------------+---------
     fast      |          2 | 1235753

  --- прогон проектора, пока A висит:
    {"mode":"project","ops":1,...}
    чекпоинт: 1235753 / 2
  --- ждём коммита A и запускаем проектор снова:
    {"mode":"project","ops":0,...}
  ИТОГ в проекции:
     stream_id | version | liters
    -----------+---------+--------
     fast      |       1 |  7.000
  ==> ПОТЕРЯ: в проекции 1 стрим(ов) из 2
Напрашивается формулировка лечения «нужна величина, монотонная относительно коммитов». Но такой величины в Postgres попросту нет — и, что важнее, она для корректности не нужна. Нужно другое свойство, более слабое и достижимое: безопасный завершённый префикс. Курсор может двигаться по любому порядку, если гарантировано, что ниже уже пройденной отметки новых строк больше не появится. Именно это даёт pg_snapshot_xmin(pg_current_snapshot()) — наименьший ещё не завершившийся xid: всё, что строго меньше, уже либо закоммичено, либо откатано, и появиться задним числом оттуда нечему. Порядок здесь — порядок выдачи идентификаторов транзакций, не порядок коммитов; безопасность даёт не монотонность коммитов, а невозможность позднего появления строки ниже водяного знака.
Разница между «монотонно по коммитам» и «безопасный завершённый префикс» — не игра слов. Первое обещало бы, что проекция видит события в порядке их фиксации; второе гарантирует только, что она не пропустит событие. Для аддитивной свёртки второго достаточно, для проекции, зависящей от порядка между стримами, — нет, и об этом отдельный абзац в конце раздела.
Отсюда три правила, каждое из которых обязательно:
- в
eventsрядом сglobal_posпишетсяxid xid8 NOT NULL DEFAULT pg_current_xact_id(); - курсор проектора — пара
(xid, global_pos):global_posостаётся упорядочивателем внутри одной транзакции; - проектор читает только события с
xid < водяного знака. Событие незавершённой транзакции не будет прочитано, пока та не закончится, — а когда закончится, еёxidокажется больше чекпоинта, и событие попадёт в выборку штатным порядком.
Водяной знак в коде снимается первой строкой транзакции, до upsert’а чекпоинта. Корректность от этого порядка не зависит: если снять его после записи, транзакция проектора уже получит собственный xid и сама окажется в снимке, так что xmin не превысит её xid. Это лишь отодвигает водяной знак назад — события ранее завершённых транзакций с меньшими xid фильтр по-прежнему пропустит. Снятие первой строкой просто не даёт собственной транзакции проектора влиять на водяной знак.
Тот же прогон с водяным знаком — проектор ждёт, вместо того чтобы обогнать незавершённую транзакцию:
--- прогон проектора, пока A висит:
    {"mode":"project","ops":0,...}
    чекпоинт: 0 / 0
  --- ждём коммита A и запускаем проектор снова:
    {"mode":"project","ops":2,...}
  ИТОГ в проекции:
     stream_id | version | liters
    -----------+---------+--------
     fast      |       1 |  7.000
     slow      |       1 |  5.000
  ==> ОБА события в проекции (2 из 2)
Цена решения — задержка, а не пропускная способность: проектор не может уйти дальше самой старой незавершённой транзакции. Одна зависшая транзакция тормозит применение всей проекции, и это ровно тот же механизм, из-за которого зависшая транзакция мешает VACUUM. Мониторинг долгих транзакций (pg_stat_activity, xact_start) из «хорошо бы» превращается в необходимость. Альтернативы — сериализовать выдачу позиций блокировкой, удерживаемой до коммита (корректно, но упирает всю запись в один сериализованный поток), или детектировать «дырки» в сиквенсе с таймаутом на признание позиции мёртвой (так делает Marten). Ни одна из них не бесплатна; выбранная здесь платит задержкой.
Отдельно стоит сказать, чего этот механизм не делает. Он не даёт порядок применения, совпадающий с порядком коммитов: события упорядочиваются по xid, то есть по выдаче идентификатора транзакции, а закоммититься две транзакции могут в обратном порядке. Для проекции с аддитивной свёрткой это неважно, для проекции, чувствительной к порядку между стримами, — важно, и такой случай эта схема не закрывает.
И ещё одно ограничение, о котором легко забыть, потому что оно проявляется не под нагрузкой, а при эксплуатации. xid8 уникален и монотонен только в пределах одной инсталляции Postgres. Логическое восстановление из дампа, миграция на новый кластер, переезд через pg_dump/pg_restore — и счётчик транзакций на новом сервере начинается заново, с величин заведомо меньших, чем сохранённый чекпоинт. Ломаются при этом сразу две вещи. Сохранённый чекпоинт больше любого нового xid, и условие xid > checkpoint.xid не пропустит ни одного нового события. Но и сброс чекпоинтов не спасает: восстановленные строки events сохраняют старые значения xid, а они больше водяного знака нового кластера, и фильтр xid < xmin не пропустит их даже при нулевом чекпоинте — пока счётчик транзакций нового сервера их не догонит. Новые события при этом получат меньшие xid и пойдут в проекцию раньше восстановленной истории. Всё это молча, как и положено корректно работающему коду с испорченными входными данными. Прикладной курсор, хранящий xid, поэтому требует явной политики на восстановление. Рабочий вариант один: пока запись остановлена, сохранённые xid всех восстановленных событий переписываются одним и тем же значением, меньшим любого xid, который выдаст новый кластер, — порядок внутри этой группы задаст вторая компонента курсора, global_pos. Затем чекпоинты сбрасываются в (0, 0), проекции пересобираются с нуля, и только после этого открывается запись. Новые события получат xid выше переписанных, и обычный проектор пойдёт по ним штатно. Пересобирать историю отдельным путём, оставив старые xid как есть, нельзя: курсор после такой пересборки нечем согласовать с новыми событиями — их xid окажутся ниже исторических. Этот протокол стенд не реализует и не проверял — он живёт в одном контейнере и переездов не переживает; в проде его надо написать и проверить до первого восстановления, а не после. Подробности про xid8 и снимки — в документации Postgres по информационным функциям.
Обрыв на середине и рестарт: числа
Стенд наполняет историю тем же профилем, что и во второй статье серии — -mode append-fine -workers 16 -streams 64 -duration 20s, 64 стрима. Затем запускает проектор с -duration 3s и обрывает его не убийством процесса, а истечением таймера между вызовами ProjectBatch: сам вызов либо коммитится целиком, либо откатывается целиком — это гарантия транзакции Postgres, Go-код внутри неё ничего не рвёт. После обрыва — второй запуск проектора до исчерпания событий.
Шесть независимых прогонов, 2026-08-13:
| прогон | событий в сторе | конфликтов при наполнении | чекпоинт после обрыва | доля от total | ops прогона 1 (обрыв) | ops прогона 2 (рестарт) | сумма ops | расхождений со свёрткой |
|---|---|---|---|---|---|---|---|---|
| 1 | 31222 | 6118 | 7169 | 0.23 | 6000 | 25222 | 31222 | 0 |
| 2 | 32144 | 6493 | 7192 | 0.22 | 6000 | 26144 | 32144 | 0 |
| 3 | 30164 | — | 7127 | 0.24 | 6000 | 24164 | 30164 | 0 |
| 4 | 32346 | — | 6535 | 0.20 | 5500 | 26846 | 32346 | 0 |
| 5 | 32245 | — | 7148 | 0.22 | 6000 | 26245 | 32245 | 0 |
| 6 | 32985 | — | 6566 | 0.20 | 5500 | 27485 | 32985 | 0 |
Первая проверка перед тем, как читать числа как доказательство — обрыв вообще пришёлся на середину, а не на старт или конец истории: во всех прогонах чекпоинт после обрыва строго между 0 и total (7169 из 31222; 7192 из 32144; 7127 из 30164; 6535 из 32346; 7148 из 32245; 6566 из 32985). Если бы обрыв случился на границе — до первой пачки или после последней — проверка ничего бы не показывала: рестарт с нулевого чекпоинта и рестарт без единого необработанного события оба тривиально проходят без потерь и дублей, потому что второй запуск в этих случаях делает всю работу или не делает её вовсе. Скрипт стенда (scripts/03-projections.sh) утверждает это ассертом [ "$mid" -gt 0 ] && [ "$mid" -lt "$total" ] до того, как переходить к сверке.
ops прогона 1 — всегда кратен 500 (6000, 6000, 6000, 5500, 6000, 5500): за отведённые 3 секунды проектор успевает обработать целое число полных пачек по 500 событий (limit в ProjectBatch), следующая не начинается — -duration истекает между вызовами ProjectBatch, а не внутри него. В последнем прогоне уместилось 11 пачек вместо 12: проектор делает на пачку на один запрос больше — водяной знак из раздела выше. Сумма ops обоих прогонов (6000+25222=31222; 6000+26144=32144; 6000+24164=30164; 5500+26846=32346; 6000+26245=32245; 5500+27485=32985) в точности равна количеству событий в сторе — на уровне подсчёта операций ни одно событие не потеряно и не обработано дважды.
Эту арифметику проверяет сам скрипт: сумма обработанного двумя прогонами обязана совпасть с count(*) таблицы events, иначе прогон падает. Проверка независима от SQL-сверки ниже — та сравнивает состояние (суммы литров), эта считает события, и потеря с двойной обработкой, взаимно скомпенсировавшиеся в балансе, здесь бы всё равно вылезли. Что ассерт умеет падать, проверено подменой ожидаемого значения на «сумма плюс один»: скрипт останавливается с сообщением о потере или двойной обработке.
Чекпоинт (7169 / 7192 / 7127 / 6535 / 7148 / 6566) не равен количеству обработанных событий прогона 1 — это ожидаемо, не расхождение. global_pos — позиция в сиквенсе events_global_pos_seq, а не порядковый номер строки: неудачные INSERT из-за конфликта версии откатывают транзакцию (ErrVersionConflict в AppendEvents), но уже забрали значение из сиквенса до отката. Эти позиции остаются «дырками», которых ProjectBatch не видит — WHERE global_pos > $1 с LIMIT просто пропускает их диапазоном, — поэтому чекпоинт обгоняет число физически обработанных строк на величину дырок внутри пройденного диапазона.
Сверка проекции со свёрткой событий (GROUP BY stream_id из events против balances, порог расхождения 0.0001 литра для защиты от округления NUMERIC) — 0 расходящихся стримов во всех шести прогонах. На всех 64 стримах после обрыва и рестарта проекция в точности равна свёртке. Но сверку такого вида легко написать так, что падать она не умеет, — это разбирает следующий раздел.
Сверка, которая не могла провалиться
Естественная форма такой сверки соединяет свёртку событий с проекцией через INNER JOIN. В репозитории стенда её нет — она приведена для разбора; в scripts/03-projections.sh только версия из следующего блока:
SELECT count(*) FROM (
  SELECT e.stream_id,
         sum(CASE WHEN e.event_type = 'OxygenAdded' THEN (e.data->>'liters')::numeric
                  WHEN e.event_type = 'OxygenConsumed' THEN -(e.data->>'liters')::numeric
                  ELSE 0 END) AS folded
  FROM events e GROUP BY e.stream_id
) f
INNER JOIN balances b USING (stream_id)
WHERE abs(f.folded - b.liters) > 0.0001;
Дефект не в пороге и не в арифметике — в самом JOIN. Если проекция теряет строку для какого-то stream_id целиком, свёртка f (она строится из events, независимо от состояния balances) эту строку по-прежнему содержит, а INNER JOIN тихо выбрасывает её из результата, потому что пары в balances больше нет. diff_rows в этом случае остаётся 0 — сверка объявляет успех при потерянном стриме, что и является максимально тихим отказом: проверка не упала, потому что строка, на которой она должна была упасть, физически не попала в набор данных, который сравнивается.
На прогонах выше это не проявлялось — не потому, что дефекта нет, а потому, что первое событие любого стрима сразу заводит строку в balances. Это свойство текущей реализации ProjectBatch, а не гарантия, которую даёт сама сверка. Любой будущий сбой, из-за которого стрим целиком выпадет из обработки — ошибка в диапазоне global_pos, ручной сброс чекпоинта назад мимо уже обработанного стрима, фильтр по типу события, добавленный неаккуратно — остался бы незамеченным именно потому, что сверка молчит там, где должна кричать.
Исправление — FULL OUTER JOIN вместо INNER JOIN, с расхождением по трём условиям: числа разошлись; f.stream_id заполнен, а b.stream_id пуст (стрим есть в событиях, отсутствует в проекции); b.stream_id заполнен, а f.stream_id пуст (обратный случай — проекция знает о стриме, которого нет в истории):
SELECT count(*) FROM (
  SELECT e.stream_id,
         sum(CASE WHEN e.event_type = 'OxygenAdded' THEN (e.data->>'liters')::numeric
                  WHEN e.event_type = 'OxygenConsumed' THEN -(e.data->>'liters')::numeric
                  ELSE 0 END) AS folded
  FROM events e GROUP BY e.stream_id
) f
FULL OUTER JOIN balances b USING (stream_id)
WHERE f.stream_id IS NULL
   OR b.stream_id IS NULL
   OR abs(f.folded - b.liters) > 0.0001;
Доказательство, что вторая версия действительно ловит потерю стрима, а не просто выглядит строже — прямая порча данных на здоровом прогоне с 31222 событиями и 64 стримами (2026-08-13). Стрим tank-0 перед порчей:
$ docker exec -i esd-postgres psql -U esdemo -d esdemo \
    -c "SELECT * FROM balances WHERE stream_id = 'tank-0'"
 stream_id | version |    liters
-----------+---------+---------------
 tank-0    |     467 | 999999535.000
(1 row)
После DELETE 1 (стрим удалён из balances целиком, имитация потери) сверка на v2:
diff_rows на сломанных данных: 1
OK: сверка поймала потерю стрима, скрипт бы упал через fail()
После восстановления той же строки (version=467, liters=999999535.000) сверка снова проходит:
diff_rows после восстановления: 0
OK: сверка снова проходит на здоровых данных
INNER JOIN (сверка v1) на этих же сломанных данных diff_rows не поднял бы вовсе — с ним пропавшая строка выпадает из результата JOIN, а не попадает в него с расхождением, и diff_rows остаётся 0 ровно так же, как на здоровых данных. Контрольный прогон полного скрипта с FULL OUTER JOIN (2026-08-13): 30637 событий в сторе, чекпоинт после обрыва 7078 (доля 0.23 от total), сверка — 0 расходящихся стримов. Замена JOIN не меняет поведение на здоровых данных, только добавляет чувствительность к потере стрима целиком.
Мысль, ради которой стоило разбирать этот дефект в деталях: проверка, которая не может провалиться, проверкой не является. diff_rows = 0 на INNER JOIN выглядел как зелёный статус ровно в тех же случаях, что и настоящий зелёный статус, — отличить их можно было только зная механику JOIN, а не глядя на результат. Это не специфика event_sourcing-стенда: любая сверка в проде, построенная через JOIN, который умеет молча терять несовпавшую сторону — сверка выгрузки с источником, сверка остатков между сервисами, сверка платежей с банковской выпиской — несёт тот же риск, если никто не задавал себе вопрос «а какой конкретно дефект эта проверка обязана поймать, и ловит ли она его на самом деле». Стоит пойти и явно ответить на этот вопрос для сверок, которые уже работают в проде: если ответ не очевиден за минуту чтения SQL, вероятно, сверка не проверялась на умение падать никогда.
Второй слепой случай: событие неизвестного типа
Сверка, которая видит потерю стрима, всё ещё не видит кое-чего другого — и показывает это контрпример. В events кладётся событие OxygenLeaked{liters: 99} — тип, которого проектор не знает. Результат без защиты:
проектор:        ops=1, errors=0
проекция:        version=1, liters=0
сверка по сумме: diff_rows=0
Событие потеряно, версия строки повышена, чекпоинт сдвинут — и обе проверки согласованно объявили это корректным состоянием. Причина одна на двоих: в проекторе switch по типу события без ветки default оставляет дельту нулевой, а в сверке CASE ... ELSE 0 сворачивает незнакомое событие в тот же ноль. Две стороны, ошибающиеся одинаково, сходятся идеально.
Это тоньше, чем предыдущий дефект, и опаснее. INNER JOIN был неверен структурно — его можно было поймать чтением SQL. Здесь же обе стороны написаны правильно относительно того, что они знают, и молчание — прямое следствие их согласия. Никакая сверка сумм этого поймать не может в принципе: она сравнивает два числа, а неизвестный тип одинаково отсутствует в обоих.
Отсюда два вывода. Первый — проектор обязан быть fail-closed: неизвестный тип означает либо порчу данных, либо событие от более новой версии кода, и оба случая требуют остановки, а не пропуска:
$ cd go && go build -o loadgen . && ./loadgen -mode project -duration 5s
loadgen: ProjectBatch: проекция balances, стрим leak версия 1 (global_pos 1):
         неизвестный тип события "OxygenLeaked" — проектор не знает, как его
         применить, и останавливается вместо тихого пропуска
Второй — сверке нужна проверка другого рода, не арифметическая: список допустимых типов. Она идёт до сверки сумм и ловит ровно то, чего сумма не видит:
$ bash scripts/07-projector-safety.sh \
    | grep -E 'СЛЕПА|свернули незнакомое|списка типов поймала'
сверка ПО СУММЕ даёт diff_rows=0 — она СЛЕПА к неизвестному типу
  (обе стороны свернули незнакомое событие в один и тот же ноль)
проверка списка типов поймала: OxygenLeaked (1 шт.)
Родственный случай. Тип события в этой схеме хранится дважды: столбцом event_type и внутри data->>'type'. Сверка и список допустимых типов смотрят на столбец, проектор читает событие целиком и принимает решение по полю в JSON. Пока они совпадают, разницы нет; строка, где они разошлись, проходит все проверки насквозь:
event_type = OxygenConsumed      → списку допустимых типов нравится
data.type  = OxygenAdded         → проектору тоже нравится
liters     = 7                   → применяется со знаком ПЛЮС вместо минуса

projector: ops=1, errors=0, чекпоинт продвинут
unknown types: 0
Оба типа известны, поэтому проверка из предыдущего абзаца бессильна: она спрашивает «знаком ли тип», а вопрос здесь другой — «а тип-то один?». Сверка расхождение потом заметит, но проектор к тому моменту уже закоммитил неверное состояние.
Лечится это не третьей проверкой, а тем, что противоречие делается незаписываемым: ограничение CHECK (data ? 'type' AND data->>'type' = event_type) в схеме. Оно дешевле любой проверки на чтении и не требует, чтобы о нём кто-то помнил. Проверка в проекторе всё же есть — но не ради нормы, где она не сработает никогда, а ради append-only-реальности: стор переживает схемы, которые его наполняли, и строки, записанные до появления ограничения, останутся в нём навсегда. Читатель обязан проверять то, на чём строит решение, а не полагаться на аккуратность всех прошлых версий писателя. Проверена падающей — на временно снятом ограничении, то есть ровно на данных «старой схемы».
Обобщение, которое стоит унести: две проверки, ошибающиеся одинаково, не дают двух проверок. Если сверка и код, который она проверяет, разделяют одно и то же предположение — здесь «незнакомое событие ничего не меняет», — сверка проверяет не код, а согласие с собственной слепотой. Чтобы это ловить, нужна проверка, устроенная принципиально иначе: не сумма против суммы, а перечень против перечня.
Тот же вопрос я задал и третьей стороне — replay-тесту из пятой статьи. Там Tank.Apply — тоже switch без default, и он свернул бы неизвестное событие в ноль так же молча. Менять сигнатуру чистой свёртки ради этого не хотелось, поэтому проверка поставлена на границу: тест проверяет сами данные, которыми кормят replay, на список допустимых типов. Проверен падающим — дописанная в историю строка с OxygenLeaked роняет его.
Идемпотентность: guard есть, а повтора нет
Гарантия здесь — не at-least-once: событие не «придёт снова после отката». Стоит проговорить, почему именно.
Guard version = $2 - 1 в UPDATE balances SET liters = liters + $3, version = $2 WHERE stream_id = $1 AND version = $2 - 1 действительно делает применение идемпотентным: повторное событие с той же версией не пройдёт WHERE, потому что balances.version уже равен $2, а не $2 - 1. Но из наличия guard’а не следует, что повторная доставка штатно случается. В этой схеме чекпоинт и применение событий двигаются в одной транзакции (раздел выше) — откат откатывает оба эффекта разом, а следующий запуск читает события после курсора (xid, global_pos) заново с той же позиции, на которой предыдущий запуск честно остановился. Событию, которое этот запуск ещё не видел, взяться из повторной доставки неоткуда: штатная повторная доставка в этой схеме структурно невозможна.
Тогда зачем guard, если повторов не бывает? Ради сценария, который выглядит экзотикой ровно до первого инцидента: чекпоинт откатили назад руками. Восстановление checkpoints из бэкапа отдельно от таблицы проекции, сброс позиции при расследовании, «давайте перечитаем с начала и посмотрим» — администратор двигает курсор чекпоинта на более раннюю позицию, и следующий запуск ProjectBatch честно перечитывает уже применённый диапазон. Без guard’а liters = liters + delta тут удвоил бы баланс; с guard’ом повторное применение той же версии не проходит WHERE и не меняет строку. При составном курсоре «перечитать с начала» значит сбросить обе его компоненты. Сброс одного global_pos историю не перечитывает: условие xid > cur OR (xid = cur AND global_pos > 0) вернёт лишь события последней обработанной транзакции. Стенд проверяет оба варианта на одной истории (scripts/08-manual-replay.sh):
$ bash scripts/08-manual-replay.sh
# (сведено к итогам вариантов)
[08-manual-replay] событий в сторе: 36819; сумма баланса: 63999963309.000
  вариант A (SET global_pos = 0): перечитано 1 из 36819, пропущено guard'ом 1, сумма 63999963309.000
  вариант B (SET global_pos = 0, xid = '0'::xid8): перечитано 36819 из 36819, пропущено guard'ом 36819, сумма 63999963309.000
В обоих вариантах guard отсёк все повторы, и баланс не изменился.
Неоднозначный коммит (транзакция зафиксировалась на сервере, но клиент не получил подтверждения из-за обрыва) в этот список не входит. Guard здесь почти не при чём: раз коммит прошёл, вместе с балансом зафиксировался и сдвиг чекпоинта, поэтому повторный вызов ProjectBatch прочитает уже НОВУЮ позицию и тех же событий попросту не выберет. Защищает тут не guard, а та же атомарность из первого раздела. Сценарий остаётся мыслимым только для кода, который применяет события в обход ProjectBatch, — то есть для схемы, отличной от разбираемой.
У guard’а есть обратная сторона, и на неё стоит смотреть внимательно. Условие WHERE balances.version = $2 - 1 не совпадает по двум разным причинам, а ведёт себя одинаково — не меняет ни одной строки. Первая причина безобидна: версия строки уже равна $2, событие применено, повторять нечего. Вторая — потеря: версия строки СИЛЬНО меньше, между проекцией и применяемым событием пропущены события. В обоих случаях UPDATE с guard’ом молча ничего не делает, Postgres ошибкой это не считает, и если проектор на этом не остановится, транзакция коммитится, а чекпоинт в конце ProjectBatch уезжает вперёд — за пропуск. Дальше расхождение уже не догнать: события, мимо которых чекпоинт перешагнул, не будут прочитаны никогда.
Это ровно тот дефект, о котором вся статья: пропуск не выглядит как отказ. Различить случаи можно на месте, и стоит это одного запроса. Проектор смотрит на RowsAffected() и, когда изменённых строк ноль, разбирает все возможные причины поимённо.
Применение поэтому разделено на два шага, а не собрано в один INSERT ... ON CONFLICT DO UPDATE ... WHERE version = $2 - 1: в таком запросе ветка INSERT безусловна. Если строки проекции ещё нет, а первым пришло событие версии 20, INSERT создал бы строку сразу на версии 20 — RowsAffected равен единице, диагностика не запускается, девятнадцать событий пропадают молча. Поэтому сначала идёт UPDATE с guard’ом, и только если он никого не задел — разбор, где INSERT законен ровно для версии 1.
tag, err := tx.Exec(ctx, upd, r.stream, r.version, delta) // UPDATE ... WHERE version = $2 - 1
if err != nil {
	return 0, err
}
if tag.RowsAffected() == 0 {
	var have int64
	err := tx.QueryRow(ctx,
		fmt.Sprintf(`SELECT version FROM %s WHERE stream_id = $1`, table),
		r.stream).Scan(&have)
	switch {
	case errors.Is(err, pgx.ErrNoRows):
		// Стрима в проекции нет вовсе. INSERT законен ТОЛЬКО для версии 1.
		if r.version != 1 {
			return 0, fmt.Errorf(
				"разрыв версий в проекции %s: стрима %s в проекции нет, а применяется версия %d — "+
					"перед ним потеряно %d событий", table, r.stream, r.version, r.version-1)
		}
		if _, err := tx.Exec(ctx, ins, r.stream, r.version, delta); err != nil {
			return 0, err
		}
	case err != nil:
		return 0, fmt.Errorf("стрим %s версия %d: строка не изменилась и не читается: %w",
			r.stream, r.version, err)
	case have >= r.version:
		skipped++ // штатный повтор: событие уже учтено
	case have == r.version-1:
		// Версия подходит под guard, но UPDATE никого не задел — строку
		// изменили между UPDATE и этим SELECT. В однопроцессной схеме
		// стенда невозможно; если случилось, молчать нельзя.
		return 0, fmt.Errorf("проекция %s, стрим %s: конкурентная модификация", table, r.stream)
	default:
		// have < r.version-1 — разрыв. Транзакция откатится по defer,
		// чекпоинт останется на месте, следующий запуск начнёт с той же позиции.
		return 0, fmt.Errorf(
			"разрыв версий в проекции %s: стрим %s на версии %d, применяется версия %d — "+
				"между ними потеряно %d событий", table, r.stream, have, r.version, r.version-have-1)
	}
}
Ветка have == r.version-1 — не педантизм ради полноты switch. Без неё этот случай молча попал бы в «повтор», хотя означает прямо противоположное: версия строки подходит под условие UPDATE, но UPDATE её не изменил, чего в однопроцессной схеме быть не может. Считать такое повтором значило бы прятать самый тревожный из исходов в самый безобидный.
Обе проверки проверены делом, а не рассуждением. Первая — новый стрим, у которого первым приходит событие версии 20:
loadgen: ProjectBatch: разрыв версий в проекции balances: стрима gap20 в проекции нет,
         а применяется версия 20 — перед ним потеряно 19 событий
rc=1
строк в проекции: 0 (ожидается 0)
Контрольный прогон с версией 1 на том же месте проходит и создаёт строку — проверка отличает разрыв от законного начала стрима, а не запрещает вставку вообще. Вторая — чекпоинт, сдвинутый вперёд руками мимо восемнадцати событий существующего стрима:
стрим=gap-2  global_pos события версии 20 = 191
loadgen: ProjectBatch: разрыв версий в проекции balances: стрим gap-2 на версии 1,
         применяется версия 20 — между ними потеряно 18 событий
rc=1
checkpoint=190 (ожидалось 190)
Последняя строка здесь не менее важна, чем сообщение об ошибке: чекпоинт остался там, где был. Отказ, оставляющий систему в позиции, с которой можно повторить, — это принципиально другой исход, чем отказ, уехавший вперёд. Сверка из предыдущего раздела при этом никуда не девается: она по-прежнему единственное, что поймает расхождение, возникшее не в момент применения, а помимо него — правкой данных в обход проектора, например.
Пересборка без остановки чтения
Проекцию иногда приходится собирать заново с нуля: поменялась схема read-модели, нашёлся баг в проекторе, потребовалась новая проекция задним числом. Раз источник (events) воспроизводим, это в принципе решаемо реплеем — вопрос в том, можно ли сделать это, не останавливая читателей боевой таблицы, и не потерять при переключении ровно ту гарантию, о которой вся эта статья: что применение события и позиция чекпоинта не разъезжаются.
Механика дозамера (-mode rebuild-bluegreen, go/rebuild.go): теневая проекция (balances_shadow, отдельная таблица, отдельный чекпоинт balances-shadow) собирается реплеем с global_pos=0 тем же кодом ProjectBatchInto, что и боевой ProjectBatch, — пока боевой online-проектор продолжает применять события к balances, и пока независимый писатель непрерывно дописывает новые события. Эти новые события — хвост, который shadow обязана догнать до переключения; дренаж идёт, пока пачки shadow не опустеют и писатель не закончит, иначе можно остановиться раньше, чем дописан хвост.
Как только shadow догнала всё, включая хвост, — атомарное переключение: тройной ALTER TABLE ... RENAME в одной транзакции Postgres. balances становится balances_swap_tmp, balances_shadow (пересобранная проекция) занимает имя balances, а бывшая боевая занимает освободившееся имя balances_shadow. DDL в Postgres транзакционен — читатель, выполняющий SELECT ... FROM balances, либо видит старые данные целиком (снимок до коммита), либо новые целиком (после коммита); момента «таблицы balances не существует» не бывает.
Ключевая деталь: в той же транзакции, что и RENAME, чекпоинт online-проектора переносится на финальную позицию shadow. Это тот же класс дефекта, с которого статья начиналась в разделе «Чекпоинт и применение в одной транзакции» — только на этот раз не внутри одного вызова ProjectBatch, а на границе между двумя независимыми проекторами. После переключения имя balances физически указывает на данные shadow, а собственный чекпоинт online-проектора остаётся на позиции его прежнего, более медленного темпа — то есть меньше, чем то, до чего реально дореплеила shadow. Не перенеси чекпоинт — и на следующем вызове ProjectBatch online-проектор перечитает диапазон, уже применённый shadow к этой же физической таблице. Баланс при этом не задвоится: guard по версии увидит, что строки уже впереди, и пропустит повторы, как в опыте с откатом чекпоинта выше. Но тогда корректность держится на страховке, а не на инварианте «чекпоинт соответствует таблице», и любая проекция без такого guard’а здесь задвоилась бы. Перенос в той же транзакции восстанавливает инвариант — то же рассуждение о разъехавшихся коммитах, что открывало статью, только на границе между двумя проекторами.
Ещё один шаг процедуры, без которого перенос ненадёжен: online-проектор останавливается до RENAME, и стенд дожидается завершения его текущего вызова ProjectBatch. Иначе его коммит, сдвигающий тот же чекпоинт, и перенос внутри транзакции переключения гонялись бы друг с другом, и победитель определялся бы порядком коммитов. Перезапускается online-проектор уже после переключения:
func swapBlueGreen(ctx context.Context, pool *pgxpool.Pool, onlineProjector string,
	shadowFinalXid string, shadowFinalPos int64) error {
	tx, err := pool.Begin(ctx)
	if err != nil {
		return err
	}
	defer func() { _ = tx.Rollback(ctx) }()

	stmts := []string{
		`ALTER TABLE balances RENAME TO balances_swap_tmp`,
		fmt.Sprintf(`ALTER TABLE %s RENAME TO balances`, shadowTableName),
		fmt.Sprintf(`ALTER TABLE balances_swap_tmp RENAME TO %s`, shadowTableName),
	}
	for _, s := range stmts {
		if _, err := tx.Exec(ctx, s); err != nil {
			return fmt.Errorf("swap: %s: %w", s, err)
		}
	}
	// Перенос чекпоинта online-проектора — не оптимизация, а условие
	// корректности подмены: без него online применил бы уже применённые
	// shadow-события повторно (см. текст выше). Переносится ПАРА
	// (xid, global_pos) целиком — половина составного курсора оставила бы
	// его несогласованным.
	if _, err := tx.Exec(ctx,
		`INSERT INTO checkpoints (projector, global_pos, xid) VALUES ($1, $2, $3::xid8)
		 ON CONFLICT (projector) DO UPDATE SET global_pos = $2, xid = $3::xid8`,
		onlineProjector, shadowFinalPos, shadowFinalXid); err != nil {
		return fmt.Errorf("swap: перенос чекпоинта online-проектора: %w", err)
	}
	return tx.Commit(ctx)
}
Наполнение истории — тот же append-fine, 16 воркеров, 64 стрима, 20 секунд, что и в замере обрыва выше. Три прогона подряд, каждому предшествует TRUNCATE events, balances, balances_shadow, checkpoints RESTART IDENTITY (2026-08-13):
| прогон | история перед пересборкой | rebuild, мс | проиграно в shadow | продвижение online за время пересборки | хвост от писателя | проверок пробы | неудач пробы |
|---|---|---|---|---|---|---|---|
| 1 | 33438 | 20751.887763 | 36847 | 24104 | 3399 | 5340 | 0 |
| 2 | 32874 | 21171.289238 | 36800 | 24452 | 3923 | 5457 | 0 |
| 3 | 31073 | 19545.315052 | 34814 | 23164 | 3735 | 5057 | 0 |
Каждый прогон проверен четырьмя ассертами: shadow совпадает со сверткой событий до подмены (FULL OUTER JOIN, та же форма запроса, что в разделе про сверку выше, — не INNER JOIN); боевая таблица совпадает со сверткой после подмены и после того, как online синхронно доработал остаток; чекпоинт online-проектора реально продвинулся за время пересборки; проба чтения не получила ни одной ошибки. Во всех трёх прогонах расхождений по обеим сверкам — 0.
«Без остановки чтения» и «без остановки применения» здесь не фигуры речи, а то, что показывают два последних столбца таблицы. Продвижение online-проектора за время пересборки — 23164–24452 событий в трёх прогонах, заведомо больше нуля: online не просто был запущен и простаивал, а реально применял события к боевой таблице параллельно со сборкой shadow, всё то время, пока shadow реплеилась с нуля. Кстати, это число заметно ниже, чем на прогоне без водяного знака (там было 30311–31743 при сопоставимом объёме истории). Объяснение напрашивается — под непрерывной записью проектор не уходит дальше самой старой незавершённой транзакции писателя и за то же окно применяет меньше, — но назвать его установленным нельзя: A/B с включённым и выключенным водяным знаком при прочих равных не ставился, а между прогонами менялся не только он. Направление правдоподобно и согласуется с механизмом; цена у корректности здесь есть, а её точная величина этим замером не измерена. А проба чтения (SELECT stream_id, liters FROM balances LIMIT 1 каждые 3 мс) не получила ни одной ошибки из 5057–5457 попыток ни в одном из трёх прогонов — включая момент самого RENAME. Пустой результат в самом начале прогона, пока online ещё не закоммитил первую строку (pgx.ErrNoRows), в число неудач не засчитывался: это честный пустой ответ непустого запроса, а не прерывание чтения — прерыванием считались только фактические ошибки запроса или соединения, которых не случилось ни разу.
Число «проиграно в shadow» на 3–10 больше, чем сумма «история перед пересборкой» + «хвост от писателя» (36847 против 33438+3399=36837, и так по всем трём прогонам). Это не расхождение самой пересборки — сверка shadow против свёртки событий проходит с 0 во всех трёх прогонах, — а недосчёт в счётчике writer_events_appended: писатель засчитывает событие только при err == nil из вызова записи, а таймаут контекста писателя иногда истекает между тем, как транзакция зафиксировалась на сервере, и тем, как клиент получил подтверждение. Строка при этом реально попадает в events — и, соответственно, честно попадает в подсчёт shadow, — но не в счётчик писателя. На результаты ассертов это не влияет: они сверяются напрямую с balances_shadow и events, не через счётчик писателя.
Время пересборки (rebuild, мс) растёт с объёмом истории и хвоста и зависит от железа конкретного стенда — переносим не абсолютное число, а метод: shadow-таблица со своим чекпоинтом, реплей тем же кодом применения события, что у боевого проектора, атомарный тройной RENAME с переносом чекпоинта online-проектора в той же транзакции, независимая проба чтения на всё окно. Основная доля времени уходит не на сам RENAME (короткая DDL-транзакция), а на сам реплей: ProjectBatchInto, как и ProjectBatch из начала статьи, пишет каждое событие пачки отдельным INSERT ... ON CONFLICT внутри одной транзакции, без COPY или многострочного INSERT — поэтому время растёт линейно с числом событий и с ценой одного round-trip к Postgres на этом хосте, а не с каким-то особым свойством именно blue-green подмены.
Что этот дозамер не проверял, важно сказать прямо, а не подразумевать: поведение при отказе процесса на середине пересборки — ни на этапе реплея shadow, ни ровно в момент транзакции RENAME; конкуренцию нескольких одновременных пересборок над одной и той же боевой таблицей; поведение под конкурентной записью именно в момент самой транзакции RENAME — писатель в этом замере работал до начала подмены, его таймаут истекал раньше, чем стартовала транзакция переключения, а проба на всё окно была только читающей; задержки самой пробы — считался только факт ошибка/не ошибка, а не тайминг отдельных попыток, поэтому кратковременный подскок задержки при RENAME, если бы он был, этим замером не был бы виден.
Граница вывода
Показано: BIGSERIAL как единственный курсор проектора теряет события — воспроизведено задержанной транзакцией, и после перехода на пару (xid, global_pos) с водяным знаком та же постановка событие не теряет. Показано: применение события и сдвиг чекпоинта в одной транзакции переживают обрыв процесса между пачками без потерь и дублей — на объёме 31222, 32144, 30637, 30164, 32346, 32245 и 32985 событий (семь независимых прогонов), при пачке 500 событий на транзакцию (limit в ProjectBatch). Показано также, что сверка на FULL OUTER JOIN действительно обнаруживает потерю стрима целиком — проверено прямой порчей данных, а не только рассуждением о том, как должен вести себя JOIN; и что проектор отказывается работать при разрыве версий, а не пропускает событие молча — проверено искусственно созданным разрывом.
Способ обрыва — истечение таймера -duration между вызовами ProjectBatch, то есть обрыв вне транзакции. Обрыв внутри одной транзакции — kill -9 посреди COMMIT, обрыв сетевого соединения к Postgres в момент фиксации — здесь не воспроизводился. За него в этой схеме отвечает не код проектора, а атомарность транзакции самого Postgres: это гарантия СУБД, принятая как данность, а не факт, который проверил эксперимент. Разница существенна для того, что можно унести из этой статьи в другой проект: код ProjectBatch гарантирует ровно то, что применение и сдвиг чекпоинта либо оба попадут в транзакцию, либо ни один; всё, что происходит внутри самого COMMIT на стороне Postgres, — не зона ответственности этого кода и не зона ответственности этого замера.
Также не проверялись: конкурентные проекторы с одним именем projector (гонка за чекпоинт при двух одновременно запущенных инстансах); отказ ровно на границе пачки (обрыв здесь пришёлся куда-то внутрь истории, а не был специально подведён к границе LIMIT); поведение при потере данных checkpoints — проверена только потеря одной строки balances при порче для демонстрации сверки, а не потеря самого чекпоинта. Перенос выводов раздела на многопроекторную схему или на восстановление после потери таблицы чекпоинтов не обоснован этим замером.
Отдельно стоит назвать две темы, которые название статьи могло бы обещать, но которые этот стенд не мерил вовсе: несколько независимых read-моделей из одного стрима и лаг проекции как SLI в Prometheus. Про них в этой серии отдельного замера нет. Если вы искали несколько проекций или лаг как SLI — вам туда, а не в числа этой статьи.
Blue-green rebuild проекции под нагрузкой в этот список не входит: раздел «Пересборка без остановки чтения» выше закрывает его отдельным дозамером. Но и этот дозамер закрыл не всё. Не проверялось поведение при отказе процесса на середине пересборки — ни на этапе реплея shadow, ни ровно в момент транзакции RENAME. Не проверялась конкуренция нескольких одновременных пересборок над одной и той же боевой таблицей. Не проверялось поведение под конкурентной записью именно в момент самой транзакции RENAME — писатель в замере работал до начала подмены, а не во время неё. Не измерялись задержки самой пробы чтения — считались только неудачи (их 0 из нескольких тысяч попыток в каждом прогоне), а не тайминги отдельных попыток, поэтому кратковременный подскок задержки при RENAME этим замером не исключён и не подтверждён.
Демо и версии
- Demo: digital-cookbook/architecture/event-sourcing-deep — стенд
scripts/03-projections.sh,ProjectBatchс чекпоинтом в одной транзакции (go/projector.go), обрыв между вызовами и рестарт, сверкаFULL OUTER JOINпротив свёртки событий;scripts/06-rebuild-bluegreen.sh,-mode rebuild-bluegreen(go/rebuild.go) — теневая проекция, атомарное переключениеRENAMEс переносом чекпоинта, проба чтения на весь интервал;scripts/07-projector-safety.sh— воспроизводимые контрпримеры и их защиты: задержанная транзакция против курсора поBIGSERIAL, разрыв версий на новом стриме, неизвестный тип события, противоречиеevent_typeиdata->>'type', каждый с контролем. Go. - Версия на прогоне: Postgres
18.4— та же схемаevents, что в первой статье серии.


Обсуждение в Telegram
Присоединиться →