
В практической статье про Event Sourcing мы сравнили хранилища событий таблицей — на уровне «что умеет из коробки». Для выбора этого хватает, но не хватает, когда event store начинает упираться в потолок под нагрузкой: тогда важно, как именно устроены стримы и глобальная позиция, чем catch-up-подписка отличается от чтения Kafka-топика, что происходит при чтении стрима на сотни тысяч событий и как хранилище чистит место. Эта статья открывает серию «Event Sourcing: глубокое погружение» и разбирает event store изнутри — ниже уровня обзорной таблицы.
Первая статья серии. Опирается на практику ES (схема events, оптимистичная блокировка) и концепцию; дальше в серии — агрегаты, проекции, версионирование, тестирование.
В статье
- Модель данных: версия стрима и глобальная позиция
- Append с ожидаемой версией: три движка на одной нагрузке
- Точечное чтение одного агрегата
- Catch-up-подписки: шесть прогонов
- Что стенд не измерил: чтение на масштабе и чистка места
- Граница вывода
Модель данных: версия стрима и глобальная позиция
У event store две системы координат, и их легко перепутать. Версия — порядковый номер события внутри стрима одного агрегата, с неё начинается и на ней держится инвариант: команда несёт ожидаемую версию, и если кто-то опередил, версия уже занята — конфликт. Глобальная позиция — сквозной монотонный номер по всем стримам сразу, за неё цепляются проекции: «дочитал до позиции N, продолжаю с неё». Версия — про один агрегат, позиция — про порядок между всеми агрегатами. Не путать: если попытаться строить проекции по версии стрима, порядка между разными агрегатами не будет вовсе — версия 5 стрима A и версия 5 стрима B никак не упорядочены друг относительно друга.
В схеме Postgres из стенда обе координаты — обычные столбцы одной таблицы:
CREATE TABLE events (
    stream_id   TEXT        NOT NULL,
    version     BIGINT      NOT NULL,
    event_type  TEXT        NOT NULL,
    schema_ver  INT         NOT NULL DEFAULT 1,
    data        JSONB       NOT NULL,
    metadata    JSONB       NOT NULL DEFAULT '{}'::jsonb,
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now(),
    global_pos  BIGSERIAL   NOT NULL,
    xid         xid8        NOT NULL DEFAULT pg_current_xact_id(),
    PRIMARY KEY (stream_id, version),
    -- Тип события хранится дважды: столбцом и внутри data. Ограничение не
    -- даёт двум источникам истины разойтись — см. третью статью серии.
    CONSTRAINT events_type_matches_payload
        CHECK (data ? 'type' AND data->>'type' = event_type)
);
CREATE INDEX events_global_pos_idx ON events (global_pos);
-- Индекс под курсор проектора — см. оговорку про BIGSERIAL ниже.
CREATE INDEX events_cursor_idx ON events (xid, global_pos);
PRIMARY KEY (stream_id, version) — это и есть оптимистичная блокировка, без отдельного локирования. Клиент читает текущую версию, готовит следующее событие с version = текущая + 1 и вставляет. Если параллельный писатель успел раньше и занял ту же версию, вставка падает по нарушению первичного ключа (Postgres возвращает документированный код 23505, на него и ловит конфликт go/store.go стенда) — не потому, что кто-то держал лок и кого-то заблокировал, а потому, что вторая строка с тем же ключом физически не может существовать. Конфликт обнаруживается на записи, а не предотвращается заранее — это и есть оптимистичность подхода: цена платится только когда гонка реально случилась, а не на каждом чтении.
global_pos растёт через BIGSERIAL независимо от stream_id — это тот же принцип, что и в практической статье про ES, только здесь важно, что он физически отделён от версии: events_global_pos_idx — отдельный индекс, по которому проекции идут вперёд, не заглядывая в устройство отдельных стримов.
И сразу — оговорка, без которой этот столбец опасен. BIGSERIAL даёт порядок выдачи номеров, а не порядок коммитов. Значение берётся из сиквенса в момент INSERT, а видимым для читателей событие становится в момент COMMIT, и между этими моментами проходит сколько угодно времени. Транзакция может взять позицию 101 и задержаться, соседняя — взять 102 и закоммититься первой. Проектор, идущий курсором global_pos > checkpoint, увидит 102, сдвинет чекпоинт, и позже закоммиченная 101 под условие не попадёт уже никогда. Событие потеряно — молча, без ошибки, без расхождения в счётчиках. Ровно поэтому в схеме стенда рядом с global_pos лежит столбец xid, а курсором проектора служит пара, а не одно число; вся механика с водяным знаком и воспроизведение самой потери — в третьей статье серииготовится, с 3 ноября, где ей и место.
EventStoreDB держит ту же пару координат нативно (версия события в стриме плюс $all — системный стрим сквозной позиции), но без явной SQL-таблицы: гарантии те же, устройство ниже уровня API скрыто. Дальше в статье обе координаты понадобятся снова — версия объясняет conflicts в разделе про запись, глобальная позиция — задержку в catch-up-подписках.
Append с ожидаемой версией: три движка на одной нагрузке
Стенд гоняет одинаковую нагрузку по трём хранилищам: Postgres-таблица events, EventStoreDB (KurrentDB) и Kafka — 16 воркеров, 30 секунд на движок, три раунда с циклическим сдвигом порядка (чтобы холодный старт кешей не доставался систематически одному и тому же движку). digital-cookbook/architecture/event-sourcing-deep — исходники стенда и профиля.
| раунд | postgres ops | postgres конфликтов | kurrent ops | kurrent конфликтов | kafka ops | kafka конфликтов |
|---|---|---|---|---|---|---|
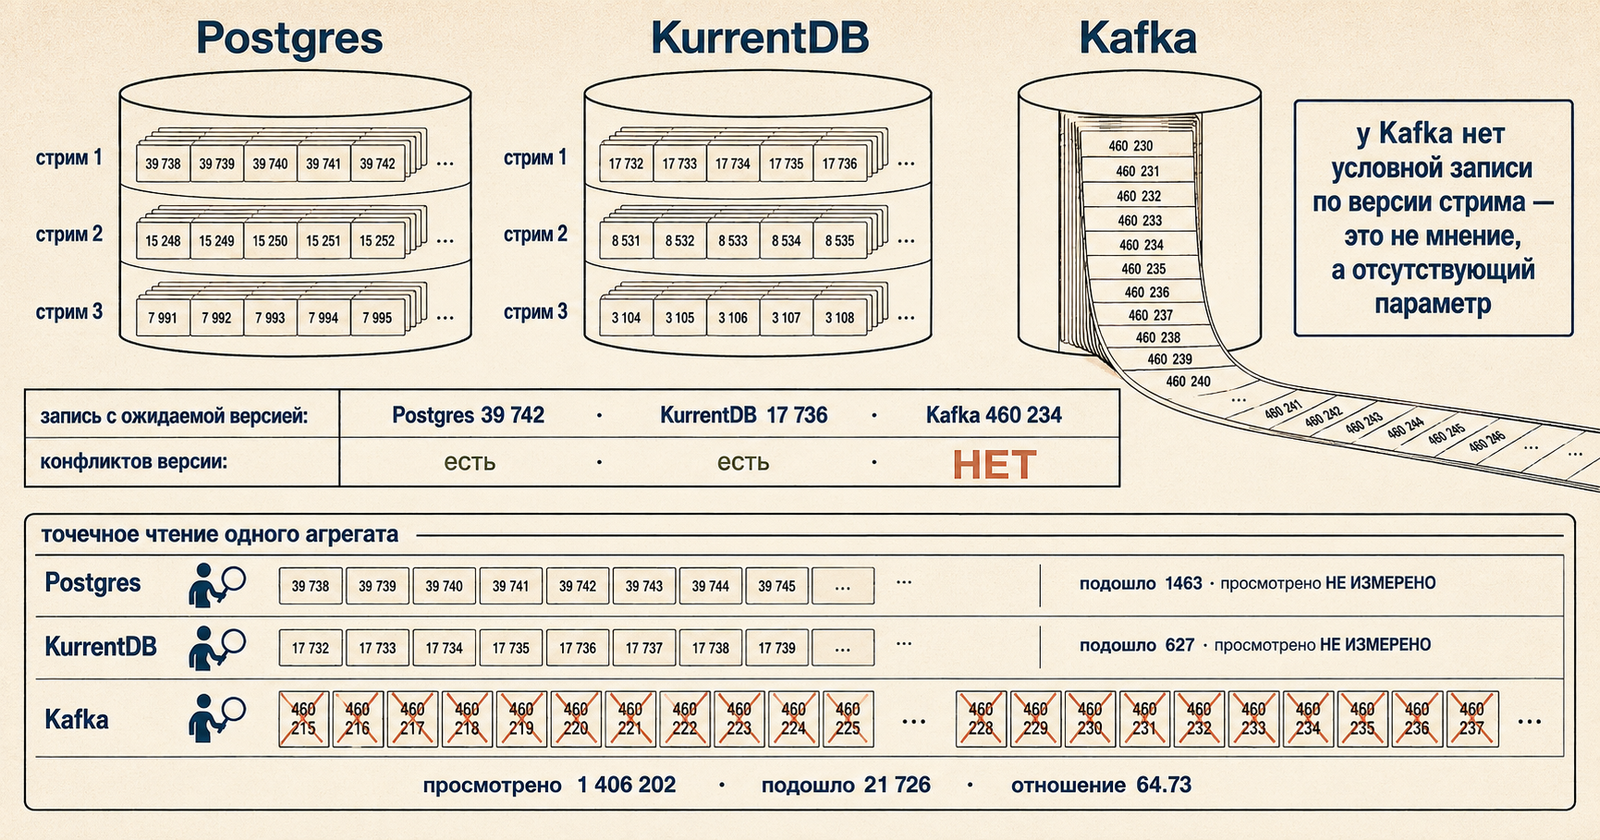
| 1 | 39742 | 7940 | 17736 | 3584 | 460234 | 0 |
| 2 | 30937 | 6228 | 12980 | 2320 | 464844 | 0 |
| 3 | 24308 | 5079 | 11253 | 1936 | 481124 | 0 |
conflicts у Kafka — 0 во всех трёх раундах, и это не «повезло». AppendKafka работает через обычный producer API, а он не принимает ожидаемую версию как параметр: условной записи по версии стрима там нет как операции. Это не мнение, это отсутствующий параметр — конфликтовать в Kafka на уровне партиции нечему в принципе, потому что нечего сравнивать при записи. Постусловие скрипта стенда (01-store.sh) проверяет это провалом при conflicts != 0 у Kafka в любом раунде.
У Postgres и KurrentDB первый раунд заметно производительнее последующих: 39742 → 30937 → 24308 у Postgres, 17736 → 12980 → 11253 у KurrentDB. Правдоподобное объяснение у обоих одно и то же: перед каждой записью читается стрим целиком (LoadStream/LoadKurrent), а стримы не сбрасываются между раундами одного прогона — только перед первым. С каждым раундом история стрима растёт, чтение перед записью дорожает.
Механизм понятен структурно — полное чтение стрима перед записью действительно линейно по длине истории, это видно из кода, а не из замера. Но именно как вывод из этого эксперимента он не обоснован, и стоит сказать прямо почему: рост истории, номер раунда и состояние машины к этому моменту меняются вместе, разделяющего замера не ставилось. Утверждение «если бы стрим сбрасывался перед каждым раундом, падения не было бы» — предсказание, а не результат: такой прогон не делался. Чтобы оно стало выводом, нужен второй ряд раундов со сбросом состояния перед каждым, чередуемый с нынешним.
А вот строго монотонным это падение называть не стоит. На трёх снятых прогонах монотонность у Postgres была / не была / была, у KurrentDB — не была / была / не была. Воспроизводится не форма кривой, а только факт «первый раунд на пустой истории заметно выше остальных».
С Kafka ловушка поучительнее. На первом прогоне её ops рос по раундам (300369 → 380651 → 413553), и это легко принять за качественное отличие: раз стрим перед записью не читается, накопленная история цены не добавляет. Второй прогон роста не воспроизвёл (181070 → 244142 → 202520, максимум в середине), третий и четвёртый — снова показали (254791 → 429447 → 432923 и 460234 → 464844 → 481124). Вывод отсюда не «Kafka разгоняется» и даже не «рост был шумом», а более скучный: направление, полученное по трём точкам одного прогона, не является результатом ни в одну сторону. Качественное утверждение здесь держится на устройстве операции, а не на форме кривой, — но и его надо очертить точно. Из того, что AppendKafka не читает стрим перед записью, следует ровно одно: у неё нет той цены, что есть у Postgres и KurrentDB — линейной по длине истории цены прикладного перечитывания стрима. Это не значит, что запись в Kafka вообще ни от чего не зависит: остаются сегменты лога, диск, retention и compaction, состояние брокера — механизмы, которых этот замер не касался. Отсутствует конкретное слагаемое, а не зависимость от нагрузки как таковая; ни один из четырёх прогонов этому не противоречит.
Сопоставлять ops трёх движков напрямую и делать из этого вывод «кто быстрее» — ловушка: за числом стоит не движок, а транспорт вокруг него — SQL-соединение на воркера у Postgres, gRPC-стрим на запрос у KurrentDB, батчируемый продюсер у Kafka. При такой разнице в механике ops будет разным всегда, и содержательного вопроса о движке в этом сравнении нет. Честно сопоставимо только то, как каждый движок ведёт себя сам с собой по раундам, — отношение конфликтов к операциям. У Postgres оно держится почти на месте (0.1998, 0.2013, 0.2089), у KurrentDB снижается (0.2021, 0.1787, 0.1720) — и это снижение повторилось на всех четырёх прогонах профиля. Объяснить его на этих данных всё равно нельзя: рост истории стрима, изменение общего ops от раунда к раунду и поведение клиента при повторной попытке здесь перепутаны в одном прогоне, разделяющего эксперимента не ставилось — факт остаётся без причины. Сама конкуренция за версию вопросов не вызывает: за три раунда — 19247 конфликтов у Postgres и 7840 у KurrentDB, у обоих оптимистичная блокировка реально работает и реально спорит за версию; у Kafka конфликтов нет вовсе, и это единственное число здесь, которое с первыми двумя сравнивать нельзя вообще — по причине из абзаца выше.
Точечное чтение одного агрегата
Профиль записи выше пишет в 64 стрима на движок (тот же профиль, что и в статье про границы агрегатаготовится, с 1 ноября) — поэтому число подошедших записей ниже нельзя напрямую делить на суммарный ops того же движка из раздела про запись: tank-<run_id>-0 получает лишь свою долю из 64 равномерно распределяемых стримов, а не весь трафик записи движка.
Центральный замер раздела — чтение одного стрима (tank-<run_id>-0) из уже наполненного хранилища:
| движок | время, мс | просмотрено записей | подошло записей |
|---|---|---|---|
| postgres | 16.925939 | не измерено (-1) | 1463 |
| kurrent | 13.772098 | не измерено (-1) | 627 |
| kafka | 656.455659 | 1406202 | 21726 |
У Kafka records_scanned — честно измеренное число: ReadStreamKafka считает каждую запись, прошедшую через consumeAllAvailable, до фильтра по ключу агрегата. Здесь 1406202 записей просмотрено против 21726 подошедших — в 64.73 раза больше, — партиция читается целиком от начала, а нужный ключ отбирается уже на стороне клиента. 1406202 — не совпадение: это точная сумма kafka ops по всем трём раундам раздела выше (460234+464844+481124=1406202), потому что точечное чтение в этом прогоне обращается к тому же топику, который наполняли раундами A, — Kafka прочитала ровно всё, что там накопилось.
records_scanned = -1 у Postgres и KurrentDB — это не измеренное равенство просмотренного и подошедшего, это сентинел «не измерено». SELECT ... WHERE stream_id = $1 у Postgres и чтение конкретного стрима у KurrentDB отбирают событие на стороне сервера — клиентский код в обоих случаях принципиально не видит строк, которые сервер не прислал, и потому не может их посчитать. Предположение «это индексный доступ, лишнего не читают» по-прежнему правдоподобно — оба запроса устроены как выборка по ключу, а не полное сканирование, — но это вывод из устройства запроса и документации движков, а не из этого замера. Выдавать отсутствие числа за равенство величин здесь нельзя: -1 не значит «просмотрено столько же, сколько подошло», это значит «мы не знаем».
Разрыв во времени большой: 656.455659 мс у Kafka против 16.925939 мс у Postgres и 13.772098 мс у KurrentDB. Соблазн сказать «вот и причина — лишние записи» здесь силён, и выглядит он обоснованным: сеть и диск будто бы исключены тем, что все три движка читали в одном прогоне на одном хосте. Общий хост исключает разницу в железе — но не изолирует искомый фактор. У трёх путей чтения различаются протокол, клиентская библиотека, объём подошедших записей (1463 против 627 против 21726) и сама выполняемая работа.
Что здесь измерено: Kafka просматривает в 64 раза больше записей, чем ей нужно, и читает заметно дольше остальных. Что не измерено: какая доля разрыва во времени приходится именно на лишние записи. Для причинного вывода нужен эксперимент внутри одного движка — одно и то же точечное чтение из топика разной наполненности при прочих равных; такого замера в стенде нет. Качественный вывод от этого не страдает: полное сканирование партиции ради одного агрегата — это устройство операции, видимое и без секундомера.
Catch-up-подписки: шесть прогонов
Здесь величины субмиллисекундные и миллисекундные, а на такой шкале единичный замер ничего не доказывает — скрипт гоняет шесть независимых прогонов подряд (CATCHUP_ROUNDS=6), по 500 предзаполненных событий на движок каждый раз с уникальным именем стрима/топика. Постусловие требует, чтобы в каждом прогоне каждый движок дочитал всю предзаполненную историю: без этой проверки «быстрый догон» мог бы оказаться подпиской, прочитавшей половину.
| движок | догон, мс | живая задержка, мс |
|---|---|---|
| postgres | 2.328965–2.647110 | 1.092731–1.250785 |
| kurrent | 4.426439–8.417622 | 0.007221–0.418032 |
| kafka | 6.991309–12.160008 | 0.387588–1.010589 |
«Догон» — время прочитать 500 предзаполненных событий с начала; «живая задержка» — сколько проходит от подтверждённой записи нового события до его наблюдения читателем подписки. Механизм за этими цифрами у всех трёх разный: у KurrentDB живая задержка — нативный пуш, сервер сам присылает событие в уже открытый gRPC-стрим подписки. У Postgres нативной подписки нет вовсе — стенд опрашивает таблицу: первый SELECT уходит сразу после подтверждения записи, а пауза 2 мс между попытками возникает, только если событие ещё не видно. У Kafka — блокирующий PollFetches на потребителе без группы, тоже опрос брокера в цикле, а не push.
Прежде чем читать числа — две границы, которые их сильно сужают.
Первая: в этом замере три движка делают разную работу на событие. Postgres догоняет через LoadStream — строки выгружаются, каждое событие десериализуется и сворачивается в состояние агрегата. KurrentDB считает пришедшие EventAppeared до сигнала CaughtUp, без доменной свёртки. Kafka получает записи, свёртки тоже нет. Postgres, таким образом, делает строго больше остальных — и всё равно догоняет быстрее; направление вывода это скорее укрепляет, но приписывать разницу устройству подписки как таковой уже нельзя: часть её объясняется тем, что сравниваются неодинаковые операции.
Вторая: live_detect_ms — это наблюдение после подтверждения записи через конкретный клиентский API, а не end-to-end задержка доставки. Таймер стартует после возврата append; к этому моменту у KurrentDB событие вполне могло уже лежать в буфере клиента подписки, и 0.008–0.038 мс измеряют, за сколько его оттуда достали. У Postgres тот же таймер меряет, по сути, один SELECT после собственной подтверждённой записи: событие видно сразу, и двухмиллисекундная пауза опроса в эти 1.1–1.3 мс не входит. Это задержка чтения своей записи, а не задержка подписки: читатель здесь не работает независимо от писателя. Чтобы измерить периодическую подписку, опрос должен идти в отдельном читателе ещё до появления события — тогда к задержке добавится и интервал опроса, в среднем половина его.
С этими оговорками — что видно. По догону KurrentDB и Kafka во всех шести прогонах без исключения медленнее Postgres, и это повторилось на четырёх независимых прогонах профиля. Точный множитель гуляет: «догон KurrentDB / догон Postgres» по прогонам — 1.67–3.61, «догон Kafka / догон Postgres» — 2.64–5.06, поэтому единственный «типичный» коэффициент стенд не приводит — только направление и диапазон.
По живой задержке KurrentDB быстрее обоих других движков в каждом из шести прогонов — это держится на всех четырёх прогонах профиля. А вот более сильное «диапазоны не пересекаются» на этом прогоне верно только против Postgres (0.007221–0.418032 мс против 1.092731–1.250785 мс): с Kafka (0.387588–1.010589 мс) диапазоны пересеклись из-за прогона 2, где у KurrentDB 0.418032 мс при обычных для неё 0.007–0.020 мс. Попарного сравнения выброс не сломал — в том же прогоне у Kafka 0.431397 мс, всё равно больше, — но раздельность диапазонов оказалась свойством прогона, а не картины. Насколько именно быстрее — тем более без ответа: отношение «живая Postgres / живая KurrentDB» по прогонам — 2.68–151.3, верхняя граница в 56.5 раза больше нижней.
Отдельно — Postgres против Kafka по живой задержке: направление устойчиво, отношение по прогонам (1→6) — 1.34, 2.60, 1.14, 1.12, 3.13, 1.44, все шесть значений больше 1, и так же было на трёх предыдущих прогонах профиля. Диапазоны в этом прогоне не пересекаются, но на одном из предыдущих пересекались — так что уносить стоит направление, а не раздельность. И помня оговорку выше: у Postgres измерено чтение своей записи сразу после коммита, а у Kafka — опрос брокера потребителем, так что сравниваются разные операции, а не «СУБД против брокера».
Что стенд не измерил: чтение на масштабе и чистка места
Вступление обещало показать, что происходит при чтении стрима на сотни тысяч событий, и как хранилище чистит место. Раздел про точечное чтение агрегата (выше) — не про это: он читает один агрегат (tank-<run_id>-0), где у Postgres и KurrentDB подошло 1463 и 627 записей соответственно — на два порядка меньше «сотен тысяч». У Kafka просмотрено 1406202 записей, но это устройство одного топика на весь прогон записи (раздел про append), а не намеренный замер чтения большого агрегата. Ни то, ни другое стенд не воспроизводил как отдельный эксперимент — ниже не замер, а изложение по документации, с явной атрибуцией по движкам.
KurrentDB освобождает место через scavenge — фоновый процесс, который физически удаляет из файлов чанков события, помеченные к удалению (по стрим-метаданным $maxAge/$maxCount или явному tombstone-стриму), и уплотняет чанки после удаления; сам scavenge стенд не запускал и не замерял (см. документацию EventStoreDB/KurrentDB).
Kafka не «чистит» события точечно вообще — топик управляется retention (по времени или по размеру, log.retention.*) и, отдельно, log compaction (для топиков с ключом хранит только последнее значение по каждому ключу, cleanup.policy=compact) — оба механизма работают на уровне сегментов лога, а не отдельных записей, и в профиле записи этой статьи (AppendKafka без компакции по ключу) ни один из них не задействован явно.
Postgres ничего не «чистит» сам — таблица events растёт монотонно, пока в неё не удаляют вручную; единственная штатная уборка здесь — VACUUM за старые версии строк после UPDATE/DELETE, а events в этой схеме только INSERT, поэтому даже обычному VACUUM практически нечего убирать. Рост таблицы без плана архивации или партиционирования — эксплуатационный вопрос, который эта статья не решает и не измеряет.
Из того же append-only следует и вопрос комплаенса, который эта статья тоже не измеряет: право на забвение нельзя реализовать физическим удалением события из неизменяемой истории — стратегии обхода (crypto-shredding, вынос PII из событий) разобраны в практической статье, раздел Append-only и право на забвение.
Граница вывода
Три хранилища здесь не участвуют в одном забеге — у них разные гарантии, разный транспорт, а у Kafka в точечном чтении и записи буквально другая операция под тем же именем. Поэтому абсолютные миллисекунды и ops из разделов выше — это снимок одного прогона на одном хосте, а не паспортная характеристика движка; в другую систему стоит уносить форму эффекта, а не цифру. Для записи форма такая: у Kafka нет условной записи по версии стрима как операции, поэтому конфликтов там не будет ни при какой нагрузке — это следствие устройства API, а не результат везения на конкретном прогоне. У Postgres и KurrentDB ops падает по мере роста истории стрима внутри одного прогона, и правдоподобное объяснение — удорожание чтения стрима перед записью. Но повторю оговорку из раздела про запись, потому что здесь легко соскользнуть обратно в категоричность: эксперимент эту причину не изолирует. Рост истории, номер раунда и состояние машины меняются вместе; разделяющего прогона со сбросом состояния не ставилось. Механизм понятен из кода — полное чтение стрима линейно по длине истории, — но подтверждён он чтением кода, а не этим замером. Форма кривой между прогонами при этом не воспроизводится, а у Kafka «рост ops по раундам» то появлялся, то исчезал от прогона к прогону — из чего следует простое правило: тренд по трём точкам, снятый один раз, не результат.
Раздел про catch-up — единственный, где измерение намеренно повторено шесть раз, и это окупилось: часть картины держится от прогона к прогону без исключений — KurrentDB быстрее обоих других движков по живой задержке во всех шести прогонах, Postgres быстрее обоих по догону истории тоже во всех шести, и то же самое было на предыдущем прогоне профиля. Это то, что имеет смысл уносить как направление — но ровно с двумя оговорками из самого раздела, без них утверждение шире измеренного: движки выполняют в этом замере неодинаковую работу на событие, а живая задержка меряет наблюдение через клиентский API после подтверждения записи, а не доставку. Точный множитель — во сколько именно раз — от прогона к прогону гуляет тем более: множитель живой задержки KurrentDB против Postgres варьируется в 56.5 раза между прогонами, против Kafka — в 129 раз; множитель догона у KurrentDB — в 2.16 раза, у Kafka — в 1.92. Занести в проектный документ конкретную кратность из одного стенда — значит выдать шум измерения за характеристику движка.
Профиль записи собран 16 воркерами на одной нагрузке — при другом их числе абсолютные ops и conflicts будут другими, и это ожидаемо: важна не цифра, а то, что воспроизводится при любом её значении — Kafka не конфликтует никогда, а Postgres и KurrentDB дорожают по мере роста истории стрима (хотя у KurrentDB не строго монотонно). Собственно решение при выборе хранилища для event store опирается именно на это, а не на миллисекунды из конкретного прогона: умеет ли движок условную запись по версии стрима из коробки, платит ли точечное чтение агрегата за полное сканирование партиции, есть ли у подписки нативный пуш или только опрос с интервалом.
Демо и версии
- Demo: digital-cookbook/architecture/event-sourcing-deep — стенд
scripts/01-store.sh, режимы append/point-read/catch-up на трёх хранилищах: EventStoreDB, Postgres-таблица, Kafka. Go. - Версии на прогоне: Postgres
18.4, KurrentDB26.1.2.3778, Apache Kafka4.3.1— модель данных и подписки чувствительны к версии, пиновать.
Документация и первоисточники
- Канон: Martin Fowler — Event Sourcing, Greg Young — CQRS Documents (PDF).
- Продукт: EventStoreDB — docs, EventStoreDB — subscriptions, Marten.
- Смежное на сайте: ES — концепция (ворота), ES на практике, проектирование агрегатов и событийготовится, с 1 ноября, проекции вглубьготовится, с 3 ноября, версионирование и upcastingготовится, с 4 ноября, тестирование и инструментарийготовится, с 5 ноября, CDC (Debezium), WAL и надёжность БД, аномалии и изоляция.
Обсуждение в Telegram
Присоединиться →