
Event store и проекции можно переделать; границы агрегатов и форму событий — почти нет, потому что они уже записаны в неизменяемую историю. Поэтому самое дорогое решение в Event Sourcing — проектное, и принимается оно до первой строки: где проходит граница агрегата (единицы согласованности и оптимистичной блокировки) и какой гранулярности события он порождает. Ошибка здесь не чинится рефакторингом — она чинится миграцией истории, а это, как мы увидим в статье про версионированиеготовится, с 4 ноября, отдельная боль.
Вторая статья серии. Опирается на первую статью (версия стрима и PRIMARY KEY (stream_id, version) как механизм оптимистичной блокировки) и на тактический DDDСкоро; дальше в серии — проекции, версионирование, тестирование. Эта статья — про моделирование: как выбирать границы агрегата (маленькие, по Вернону), как именовать события (факты, а не CRUD) и что показывает замер цены дробления стрима на конкретных числах.
В статье
- Агрегат как граница, а не объект
- Замер: один стрим на всю базу против 64
- То, что обычно замалчивают: конфликты не обнуляются
- События-факты против CRUD
- Граница вывода
Агрегат как граница, а не объект
Агрегат в Event Sourcing — не «объект с полями», а единица, внутри которой инвариант держится транзакционно и работает оптимистичная блокировка по версии: команда несёт ожидаемую версию стрима, конфликт по PRIMARY KEY (stream_id, version) — это и есть граница в действии (см. устройство версии и global_pos в первой статье серии). Если два инварианта никогда не проверяются в одной транзакции, они принадлежат разным агрегатам — даже если в предметной области выглядят как одна сущность.
Правило Вернона (Vaughn Vernon, Effective Aggregate Design) отсюда и следует: агрегаты маленькие, ссылаются друг на друга по идентификатору, а не вложением, изменяются по одному за транзакцию. Согласованность между агрегатами — eventual, инструмент для неё — не более крупная граница, а сага. Крупный агрегат — это попытка купить транзакционность там, где реального инварианта нет; цена этой покупки измеряется ниже.
Замер: один стрим на всю базу против 64
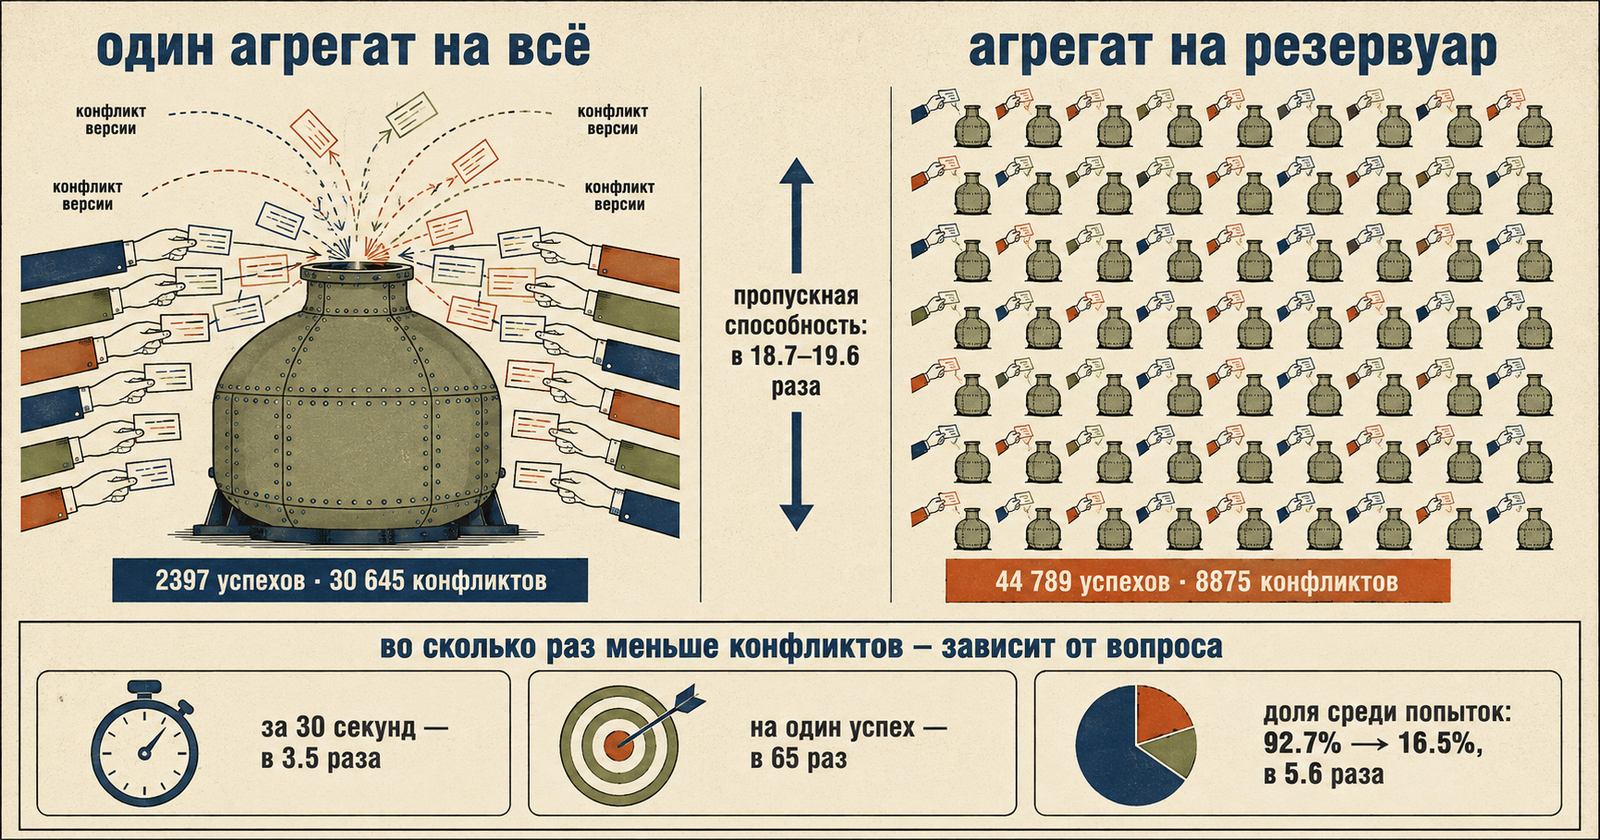
Стенд гоняет одну и ту же нагрузку на резервуары с кислородом (Tank) в двух вариантах границы: coarse — один стрим на всю базу (все резервуары пишут в один и тот же stream_id), fine — по стриму на резервуар, 64 стрима. Различается ровно число стримов: команда, домен и код общие. 16 воркеров, 30 секунд на вариант, три раунда с чередованием порядка (coarse → fine, fine → coarse, coarse → fine) — тот же приём, что и в первой статье, против систематической разницы от холодного старта.
| раунд | порядок | coarse ops | coarse конфликтов | fine ops | fine конфликтов |
|---|---|---|---|---|---|
| 1 | coarse → fine | 2397 | 30645 | 44789 | 8875 |
| 2 | fine → coarse | 2371 | 30938 | 44478 | 8698 |
| 3 | coarse → fine | 2362 | 30795 | 46272 | 9211 |
Латентности того же прогона (мс):
| раунд | coarse p50 | coarse p95 | fine p50 | fine p95 |
|---|---|---|---|---|
| 1 | 12.319570 | 21.997432 | 8.587865 | 13.876308 |
| 2 | 12.278728 | 22.047454 | 8.291223 | 15.466195 |
| 3 | 12.709335 | 21.326671 | 8.297738 | 13.553485 |
Важная деталь постановки, без которой числа ниже читаются неправильно: ретраев в генераторе нет намеренно. Конфликт версии — предмет замера, и гасить его повтором значило бы прятать измеряемое явление. Поэтому каждая попытка команды попадает ровно в один из двух счётчиков: успех идёт в ops, конфликт — в конфликты, повторной попытки за ним не следует. Все величины ниже — про попытки, а не про судьбу команды, которую клиент повторял бы до успеха.
При одном стриме на всю базу пропускная способность падает в 18.7–19.6 раза относительно 64 стримов (2362–2397 ops против 44478–46272 ops; отношение по раундам — 18.68, 18.76, 19.59). Раунд 2, где порядок обратный (fine → coarse), даёт то же соотношение, что раунды 1 и 3: результат воспроизводится при обоих порядках и на эффект очерёдности не похож. Сказать сильнее — «значит, дело в числе стримов, а не в дрейфе машины» — было бы натяжкой: чередование ослабляет гипотезу о систематическом преимуществе того, кто шёл первым, но дрейф хоста оно не изолирует. Для этого нужны прогоны, разнесённые по времени и по состоянию машины, а не переставленные внутри одного.
То, что обычно замалчивают: конфликты не обнуляются
Распространённое ожидание от дробления границы — что мелкие агрегаты снимают конфликты версий полностью: раз резервуары теперь пишут в разные стримы, воркерам больше не за что спорить. Замер это ожидание не подтверждает. У fine на каждые пять успешных операций по-прежнему приходится примерно один конфликт.
Но прежде чем говорить, «во сколько раз стало лучше», надо решить, о чём вопрос — потому что ответов здесь три, и различаются они на порядок. Типичные ошибки здесь две: смешать первые две величины и назвать вторую «вероятностью», чем она не является.
| величина | coarse | fine | отношение |
|---|---|---|---|
| конфликтов за 30 секунд | 30645–30938 | 8698–9211 | 3.45, 3.56, 3.34 — примерно втрое |
| конфликтов на один успех | 12.78–13.05 | 0.1956–0.1991 | 64.52, 66.73, 65.50 — примерно в 65 раз |
| доля конфликтов среди попыток | 92.7–92.9% | 16.4–16.6% | 5.61, 5.68, 5.59 — примерно в 5.6 раза |
Все три строки посчитаны из одной таблицы выше, и все три верны. Разброс между «втрое», «в 65 раз» и «в 5.6 раза» — не расхождение в данных, а разные вопросы.
Конфликтов за фиксированное время стало меньше всего втрое, потому что мелкие агрегаты успевают сделать в 19 раз больше полезных операций: на каждую операцию конфликтов кратно меньше, но самих операций кратно больше, и произведение почти компенсируется. Это про нагрузку на СУБД и на CPU — сколько мусорной работы система выполнит за час.
Конфликтов на один успех — 12.9 против 0.2, отсюда и 65 раз. Величина осмысленная: она говорит, сколько неудачных попыток пришлось на одну удавшуюся. Чем она не является — вероятностью. Вероятность лежит в интервале от нуля до единицы, а 12.9 туда не помещается; и назвать её «вероятностью ухода конкретной команды в retry» вдвойне нельзя: retry в этом эксперименте нет вовсе, каждая попытка учитывается отдельно и не повторяется. Величина 12.9 читается иначе: если бы клиент повторял команду и частота конфликтов при этом не менялась, на один успех в среднем пришлось бы около 13 повторов. Это модель, а не измерение.
Доля конфликтов среди попыток — вот это доля в строгом смысле: конфликты / (конфликты + успехи), от 0 до 1. И она даёт третий множитель: 92.8% против 16.5%, то есть снижение в 5.6 раза. Меньше эффектного «в 65 раз», но именно эта величина отвечает на вопрос «какая доля обращений упрётся в конфликт», и именно её стоит называть, когда говорят о вероятности.
Практический вывод не меняется от выбора величины — дробление помогает по всем трём, — но число, вынесенное в проектный документ, обязано быть подписано вопросом, на который отвечает. «Конкуренция снизилась в 65 раз» без подписи — фраза, которая при проверке рассыпается.
Почему конфликты не обнулились: 64 стрима на 16 воркеров всё ещё оставляют ненулевую вероятность, что два воркера случайно выберут один и тот же стрим одновременно — стримов больше воркеров в четыре раза, а не бесконечно больше. Это гипотеза о механизме, а не измеренный факт: частоту таких совпадений стенд не считал и с наблюдаемыми числами конфликтов не сверял. Проверить её значило бы логировать, какой воркер в какой момент какой стрим выбрал, и сопоставить с фактическими конфликтами — здесь этого нет.
Практическое следствие: retry-цикл на конфликт версии — не костыль для плохо спроектированных агрегатов, а часть контракта оптимистичной блокировки при любой границе. Дробление снижает долю конфликтующих попыток с 92.8% до 16.5%, но не до нуля — и клиент, у которого retry не написан, при мелких агрегатах будет ронять примерно каждую шестую команду вместо примерно тринадцати из четырнадцати.
События-факты против CRUD
Разница между OxygenConsumed и OrderUpdated не в стиле именования — в том, что можно построить над событием без дополнительных данных. Apply в стенде — чистая свёртка состояния:
// Event — факт в прошедшем времени. НЕ CRUD: OxygenConsumed, а не TankUpdated.
// Разница не косметическая: проекцию текущего значения на «Updated» построить
// можно, а вот величину и причину изменения — нет, не заглянув в предыдущее
// состояние.
type Event struct {
	Type   string  `json:"type"`
	Liters float64 `json:"liters"`
}

// Tank — агрегат «резервуар». Граница согласованности и оптимистичной
// блокировки: инвариант «остаток не уходит в минус» держится внутри него.
type Tank struct {
	Registered bool
	Liters     float64
}

func (t Tank) Apply(e Event) Tank {
	switch e.Type {
	case "TankRegistered":
		t.Registered = true
	case "OxygenAdded":
		t.Liters += e.Liters
	case "OxygenConsumed":
		t.Liters -= e.Liters
	}
	return t
}
Здесь легко доказать больше, чем есть: заявить, что TankUpdated{Liters: 95} вообще нельзя применить, не заглянув в предыдущее состояние. Это неправда: для проекции «текущий остаток» state-transfer-событие применяется тривиально — bal.Liters = e.Liters, обычный upsert абсолютного значения, никаких дополнительных запросов. Более того, у такой проекции есть приятное свойство: она идемпотентна сама по себе, повтор события ничего не портит, потому что присваивание, а не прибавление.
Разница появляется, когда проекции нужно не текущее значение, а что произошло: величина изменения, его направление и причина. OxygenConsumed{Liters: 5} несёт факт расхода; TankUpdated{Liters: 95} несёт только результат — было 100 и потратили 5 или было 90 и добавили 5, из самого события не следует. Всё, что строится на дельте, требует предыдущего состояния: расход за сутки, средний расход, алерт «потратили больше 10 литров за раз», история операций, пересечение порога (событие «остаток упал ниже 20» нельзя отличить от «остаток был ниже 20 и остался», не зная предыдущего).
Отсюда точная формулировка: state-transfer-событие не мешает построить проекцию текущего значения, но лишает читателя информации о переходе — и каждая проекция, которой переход нужен, обязана восстанавливать его самостоятельно, обращаясь к предыдущему состоянию. При нескольких таких проекциях над одним стримом эта работа повторяется в каждой; событие-факт записывает её один раз на записи. Ниже — код именно этого случая, проекции дельты, а не проекции остатка:
// Из события-факта расход берётся прямо: e.Liters=5 и есть ответ на вопрос
// "сколько потрачено". Дополнительных запросов нет.
func AddConsumedFromFact(total *float64, e OxygenConsumed) {
	*total += e.Liters
}

// Из state-transfer-события расход приходится ВОССТАНАВЛИВАТЬ: 95 само по
// себе не говорит, было 100 (расход 5) или было 90 (пополнение 5).
func AddConsumedFromUpdate(ctx context.Context, db *sql.DB, total *float64, e TankUpdated) error {
	var prevLiters float64
	if err := db.QueryRowContext(ctx,
		`SELECT liters FROM balances WHERE stream_id = $1`, e.StreamID,
	).Scan(&prevLiters); err != nil {
		return err
	}
	if delta := prevLiters - e.Liters; delta > 0 {
		*total += delta // 100 - 95 = 5 потрачено
	}
	return nil
}

// А вот проекция ТЕКУЩЕГО ОСТАТКА из того же state-transfer-события —
// тривиальна и никакого предыдущего состояния не требует. Ради честности
// сравнения она здесь и стоит.
func ApplyBalanceFromUpdate(bal *Balance, e TankUpdated) {
	bal.Liters = e.Liters
}
Сигнатуры делают разницу явной, и делают её ровно там, где она есть: AddConsumedFromFact принимает только событие, AddConsumedFromUpdate — событие, соединение с базой и контекст, а ApplyBalanceFromUpdate снова только событие. То есть дело не в форме события самой по себе, а в паре «форма события — вопрос проекции». Событие-факт отвечает и на вопрос о переходе, и на вопрос о состоянии (состояние набирается свёрткой); state-transfer отвечает только на второй, а первый заставляет каждого читателя добывать самостоятельно.
Decide в том же файле показывает вторую половину контракта — команда превращается в события только через проверки агрегата, а не пишется напрямую в хранилище: изменение состояния без прохождения через Decide в командном пути этой модели невозможно, потому что состояния как отдельно хранимой строки нет — есть только цепочка событий и Apply, который её сворачивает. Оговорка «в командном пути» здесь не формальность: статья про версионированиеготовится, с 4 ноября засевает стрим прямым SQL INSERT в обход Decide/AppendEvents — обычный путь записи закрыт извне командой, но не физическим ограничением таблицы events.
Само же «проверить инвариант» — место, где легко недоделать работу. Если ConsumeOxygen проверяет ровно один инвариант — «не больше остатка», — кажется, что этого достаточно, ведь именно он и есть правило домена. Но команда «потратить −5 литров» такую проверку проходит беспрепятственно (условие -5 > остатка ложно при любом неотрицательном остатке), а Apply вычитает отрицательное — то есть команда «потратить» увеличивает запас, и в неизменяемой истории это остаётся навсегда. Из той же семьи NaN: любое сравнение с ним ложно, поэтому он проскакивает обе проверки и отравляет свёртку необратимо — после него остаток равен NaN на любом продолжении истории. И регистрация: AddOxygen на незарегистрированном резервуаре без проверки создаст стрим без TankRegistered в начале, неотличимый от стрима с потерянным первым событием.
Мораль, переносимая за пределы этого домена: инвариант бизнес-правила («остаток не уходит в минус») и входные условия команды («величина — конечное положительное число», «агрегат существует») — разные проверки, и вторые не следуют из первых. В обычной CRUD-модели ошибка такого рода чинится UPDATE; в event-sourced — нет, потому что событие уже записано, и единственный способ «отменить» его — записать компенсирующее, которое тоже останется в истории навсегда. Табличный тест на все одиннадцать случаев отказа лежит в go/aggregate_test.go — и, как положено, проверен падающимготовится, с 5 ноября на версии Decide с одной проверкой остатка: пять строк из одиннадцати она пропускает.
Граница вывода
Замер выше — про цену конкуренции за версию при 1 стриме против 64 при фиксированных 16 воркерах: он показывает, что дробление снижает долю конфликтующих попыток примерно в 5.6 раза (а число конфликтов на один успех — примерно в 65 раз, а их абсолютное число за то же время — примерно втрое; см. разбор трёх величин выше) и поднимает пропускную способность в 18.7–19.6 раза, и что снижение конфликтов не доходит до нуля. Ретраев в замере нет — все величины про попытки, а не про судьбу команды, которую клиент повторял бы до успеха. Это форма эффекта, которую стенд наблюдал при 16 воркерах; воспроизводимость при другом их числе не проверялась — доля конфликтов зависит именно от числа писателей сильнее, чем любая другая величина в этом замере, и переносить наблюдение на другое число воркеров без проверки было бы поспешно. Абсолютные ops и conflicts при другом числе воркеров и другой длительности прогона будут другими в любом случае — это не паспортные цифры для любой нагрузки.
Чего замер не показывает вовсе — где именно проводить границу. Он отвечает на вопрос «что стоит один общий стрим против дробления по резервуару», но не на вопрос «можно ли раздробить границу ещё сильнее» и не на вопрос «что при этом происходит с инвариантами, которые раньше держались одной транзакцией». Мелкие стримы снимают конкуренцию за версию, но платой за это может быть инвариант, охватывающий несколько агрегатов сразу — например, «суммарный запас кислорода по всей базе не превышает ёмкость хранилища» — который при дроблении перестаёт держаться транзакционно, потому что для него больше нет одной строки с одной версией, за которую можно было бы конкурировать. Этот случай стенд не воспроизводит и не измеряет: числа выше говорят только про конкуренцию внутри одного инварианта на одном стриме, а решение, где остановить дробление, определяется границами инвариантов в предметной области, а не пропускной способностью хранилища.
Демо и версии
- Demo: digital-cookbook/architecture/event-sourcing-deep — стенд
scripts/02-design.sh, домен «резервуар с кислородом» (go/aggregate.go) в двух вариантах границ:coarse(один стрим на всю базу) иfine(стрим на резервуар, 64 стрима); события-факты (Apply/Decide) без CRUD-веток. Go. - Версия на прогоне: Postgres
18.4(та же схемаevents, что в первой статье серии) — пиновать вместе с остальными версиями стенда.
Документация и первоисточники
- Канон: Vaughn Vernon — Effective Aggregate Design (PDF, 3 части), Martin Fowler — DDD Aggregate, Greg Young — CQRS Documents (PDF), Alberto Brandolini — EventStorming.
- Смежное на сайте: тактический DDD (агрегаты)Скоро, ES — концепция, ES на практике, event store вглубь, проекции вглубьготовится, с 3 ноября, версионирование и upcastingготовится, с 4 ноября, тестирование и инструментарийготовится, с 5 ноября, saga на практике (согласованность между агрегатами).

Обсуждение в Telegram
Присоединиться →