
Иногда нужно, чтобы ровно один экземпляр сервиса делал что-то в один момент: обрабатывал задачу, запускал миграцию, был лидером. Распределённая блокировка выглядит просто, но это одна из самых коварных тем: блокировка без fencing token не защищает от «уснувшего» владельца, а наивный Redlock вызвал многолетний спор о корректности. Часто правильный ответ — спроектировать так, чтобы блокировка была не нужна.
Третья статья серии «System design: resilience». Всё ниже проверено на стенде architecture/resilience/locking: там и порча данных без защиты, и её отсутствие с защитой — воспроизводимо, а не на словах.
В статье
- Зачем координация — три задачи, которые кажутся одной
- Почему распределённый лок сложнее локального — нет ни общей памяти, ни общих часов
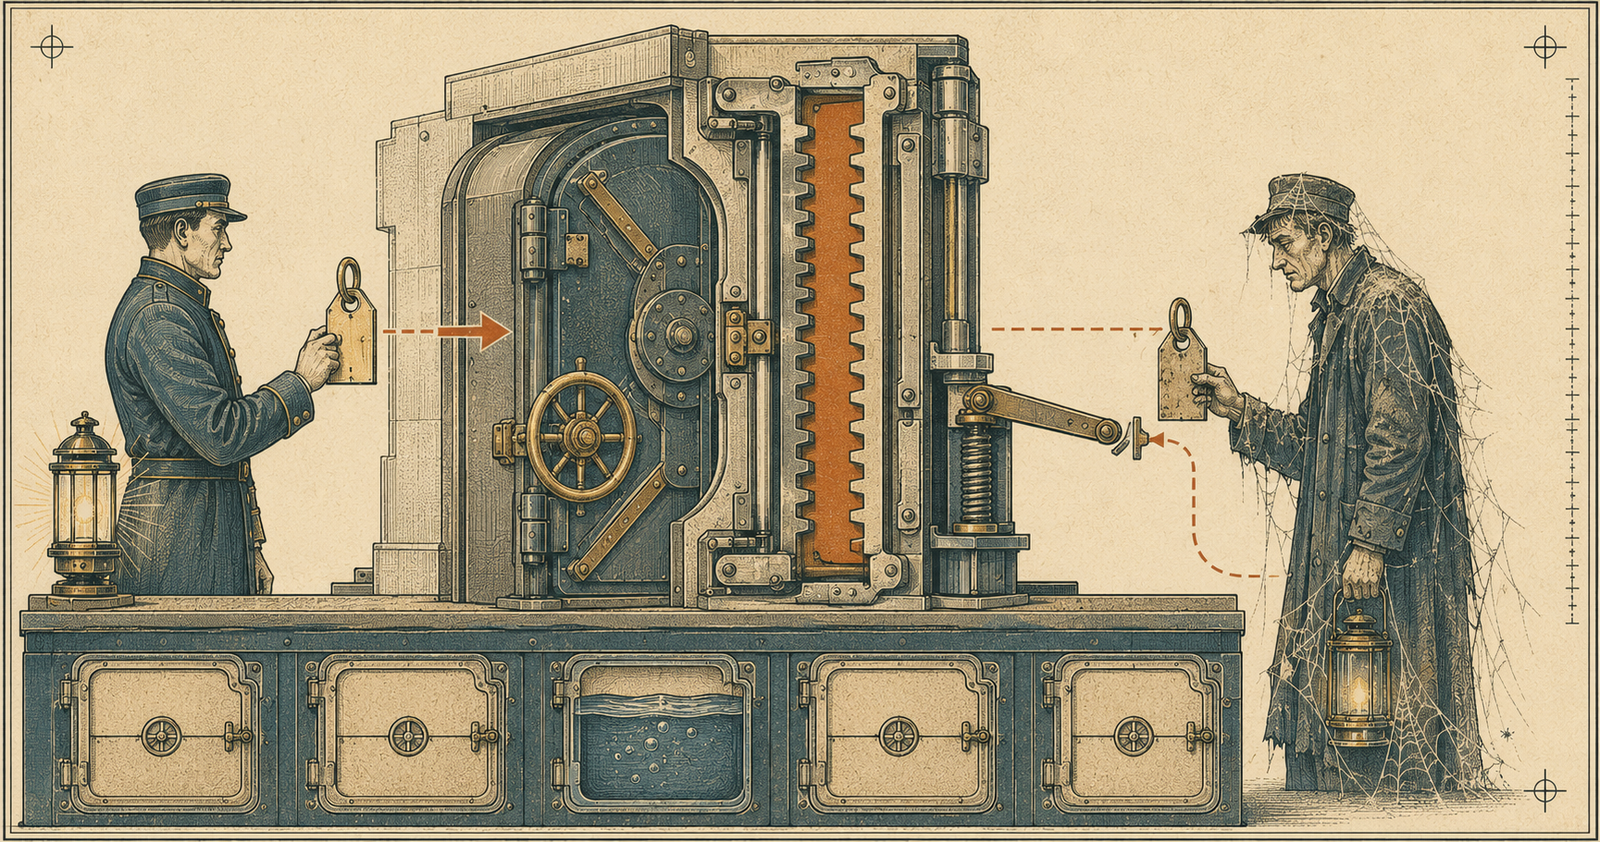
- Уснувший владелец — как TTL-лок допускает двух хозяев
- Fencing-токен — что на самом деле защищает
- Redis и спор о Redlock — без вердикта, но с конкретным сценарием
- etcd: корректный примитив — lease, выборы и revision вместо самоделки
- Как обойтись без блокировки — обычно лучший ответ
- Checklist
Зачем координация
Под «нужна блокировка» обычно скрываются три разные задачи:
- Эксклюзивная задача — периодическую работу должен выполнить ровно один инстанс, а не все пять по расписанию (подробнее про этот класс — в распределённом cronготовится, с 19 сентября).
- Лидер — один инстанс принимает решения или владеет ресурсом, остальные ждут своей очереди.
- Single-writer к данным — не допустить одновременной записи в одну сущность.
Различать их важно, потому что у третьей задачи почти всегда есть решение без распределённого лока — на стороне базы. К этому вернёмся.
Почему распределённый лок сложнее локального
Локальный мьютекс работает, потому что у потоков есть общая память и общий планировщик: владение однозначно. В распределённой системе нет ни того, ни другого — только сообщения, которые могут задержаться, и часы, которые идут по-разному.
Отсюда неизбежность TTL: если владелец лока умрёт, лок должен освободиться сам, иначе система встанет навсегда. Но TTL немедленно порождает проблему: срок может истечь, пока владелец жив. Долгая пауза сборщика мусора, вытеснение процесса, зависшая сеть — и владелец продолжает считать, что держит лок, хотя тот уже отдан другому.
Это не редкий сбой, а нормальная работа системы: пауза в сотни миллисекунд — обычное дело, а лок с TTL в секунды выглядит «безопасным».
Уснувший владелец
Сценарий, который сделал тему знаменитой (его подробно разобрал Мартин Клеппманн):
- Владелец A берёт лок и начинает работу.
- A «засыпает» — пауза GC дольше TTL.
- TTL истекает, лок свободен. Владелец B берёт его и пишет свои данные.
- A просыпается. Он не знает, что потерял лок, и тоже пишет.
Итог — двое считали себя владельцами, и запись A затёрла свежие данные B. Стенд воспроизводит это буквально:
| ресурс | итог |
|---|---|
| без fencing | A-stale — свежие данные B затёрты |
| с fencing | B-data — запоздавшая запись A отвергнута |
Ключевой вывод: сам по себе лок этого не лечит. Ни один TTL-лок не может гарантировать, что владелец узнает о потере владения вовремя, — сообщение об этом может просто не успеть.
Fencing-токен
Лечит не лок, а ресурс. Fencing-токен — монотонно растущий номер, который выдаётся вместе с локом; владелец несёт его к ресурсу при каждой записи, а ресурс отвергает всё, что старее уже принятого.
В сценарии выше: A получил токен 1, B — токен 2. B записал с токеном 2, ресурс запомнил «видел 2». Запоздавшая запись A с токеном 1 отвергается — не потому, что A узнал о потере лока, а потому, что ресурс сам умеет отличать устаревшего писателя.
Отсюда два практических следствия:
- Токен должен проверять ресурс. Если хранилище не умеет условную запись «применить, только если номер не меньше», fencing не работает — сколько бы токенов ни выдавал лок-сервис.
- Токен должен быть монотонным. Не время (часы разъезжаются), а номер, который выдаётся строго возрастающим: счётчик или версия/revision от координатора.
- Токен должен выдаваться атомарно с локом. Если захват и выдача номера — две отдельные операции, возможно чередование: A взял лок, уснул до получения номера, TTL истёк, B взял лок и номер, записал; A проснулся, получил номер больше — и затёр данные B, уже не владея локом. Стенд это воспроизводит, поэтому и лок, и токен там выдаёт одна атомарная операция.
Redis и спор о Redlock
Redlock — алгоритм распределённой блокировки на нескольких независимых Redis. Вокруг его корректности идёт давний спор: Клеппманн разбирает его как небезопасный при паузах и рассинхроне часов, Антирез (автор Redis) отвечает, что модель угроз и допущения были другими. Вердикт здесь выносить не будем — вместо этого посмотрим на конкретный, воспроизводимый сценарий.
На стенде обычный лок на Redis (SET key owner NX PX ttl): владелец A взял лок с TTL и «уснул»; TTL истёк; B взял освободившийся лок. Оба живы и оба считают себя владельцами — двойное владение зафиксировано. Именно fencing-токены (на стенде — монотонный INCR) не дают этому испортить данные.
Ещё одна деталь, которую часто пропускают: снимать лок нужно только свой. Наивное «проверил владельца, потом удалил» двумя командами разъезжается — между проверкой и удалением TTL может истечь и лок достанется другому, а вы снимете чужой. На стенде это одна атомарная Lua-операция: сравнить владельца и удалить.
И следом менее очевидное: идентификатор владельца должен быть уникален для каждого захвата, а не быть стабильным именем вроде хоста, pid или worker-1. Иначе ломается сценарий, который выглядит совершенно невинно: воркер взял лок, TTL истёк, тот же воркер взял лок заново — а запоздавшее освобождение от первого захвата снимает второй, живой лок. Формально «свой» лок и снят, а фактически чужой. Поэтому на стенде идентификатор генерируется случайным внутри API захвата, и отдать его наружу вызывающему негде.
Практический вывод про Redis-локи: они уместны как оптимизация («обычно работу делает один инстанс — не будем дублировать усилия»), но не как гарантия корректности. Если от эксклюзивности зависит целостность данных, нужен либо fencing на стороне ресурса, либо примитив с настоящими гарантиями.
etcd: корректный примитив
etcd (и ZooKeeper в той же роли) дают то, что в Redis приходится собирать вручную:
- Lease с TTL — сессия, которую владелец продлевает; отвалился — лидерство уходит автоматически.
- Выборы — примитив leader election, а не самодельная схема на ключах.
- Монотонная revision — глобальный номер версии хранилища, который уже является fencing-токеном: его не нужно заводить отдельно.
На стенде два кандидата по очереди выигрывают выборы, и revision ключа лидера растёт: 2 → 4. Это и есть готовые fencing-токены — координатор выдаёт их по построению.
Цена — отдельный кластер координатора, который надо эксплуатировать, и линеаризуемость, за которую платят латентностью. За этими гарантиями стоит консенсус: как он работает и почему стоит дорого — в карте консенсуса. Часто etcd в системе уже есть (например, под распределённую конфигурацию) — тогда брать координацию оттуда разумнее, чем городить своё.
Как обойтись без блокировки
Самый надёжный лок — тот, который не нужен. Прежде чем вводить координацию, стоит проверить три обходных пути:
- Идемпотентность. Если операцию безопасно выполнить дважды, эксклюзивность перестаёт быть обязательной: пусть выполнят двое, результат один (как это делается — в гарантиях доставки и идемпотентности).
- Оптимистическая блокировка. Вместо «захватить и держать» — запись с проверкой версии:
UPDATE ... WHERE version = N. Конфликт виден по нулю затронутых строк, повторяем. По сути тот же fencing, только встроенный в базу (см. уровни изоляции и аномалии). - Разделение по ключу. Если поток задач партиционирован так, что каждую сущность обрабатывает всегда один и тот же потребитель, эксклюзивность получается из маршрутизации, а не из лока.
Распределённая блокировка оправдана, когда обойти её нельзя: неидемпотентная операция во внешней системе, которая не умеет условную запись, — и тогда сразу с честным пониманием её границ.
Checklist
- Сформулировано, какая из трёх задач решается: эксклюзивная работа, лидер или single-writer.
- Проверены альтернативы: идемпотентность, оптимистическая блокировка, разделение по ключу.
- Если лок всё же нужен: понятно, что происходит при паузе владельца дольше TTL.
- Ресурс проверяет fencing-токен — иначе двойное владение испортит данные независимо от лока.
- Токен монотонный (счётчик или revision координатора), а не отметка времени.
- Лок снимается атомарно и только свой.
- Решено, лок — это гарантия корректности или лишь оптимизация; от ответа зависит выбор Redis против etcd/ZooKeeper.
Первоисточники
- Martin Kleppmann, «How to do distributed locking» — разбор сценария уснувшего владельца и fencing-токенов.
- Salvatore Sanfilippo, ответ автора Redis — другая сторона спора о Redlock.
- Redlock — описание алгоритма в документации Redis.
- etcd concurrency: lease и election — примитивы координации.
- Все демонстрации — со стенда architecture/resilience/locking.

Комментарии