
Есть тонкая, но принципиальная разница: rate limiting защищает вас от конкретного клиента, а backpressure и load shedding защищают систему от самой себя, когда суммарная нагрузка превысила то, что она физически тянет. Наивная реакция — «поставим очередь побольше» — делает только хуже: неограниченный буфер копит запросы, которые уже никому не нужны (клиент отвалился по таймауту), пока не кончится память. Правильная реакция — либо притормозить источник (backpressure), либо сознательно отбросить лишнее (load shedding). Эта статья — про механику самозащиты под перегрузом.
Часть серии «System design: resilience». Дополняет rate limiting и resilience-паттерны взглядом «изнутри перегруженного сервиса»: не «как отбить чужой всплеск», а «что делать, когда я сам не успеваю».
В статье
- Проблема неограниченной очереди
- Backpressure: сигнал «медленнее» вверх по цепочке
- Load shedding: сознательный сброс
- Приоритезация и graceful degradation
- Adaptive concurrency: динамический лимит
- Чем это отличается от rate limiting и circuit breaker
- Checklist
- Из практики
- Что дальше
Проблема неограниченной очереди
Первая реакция на перегруз почти у всех одинаковая: «запросы не помещаются — поставим очередь побольше». Интуиция подсказывает, что буфер сглаживает всплески. Для коротких всплесков это правда. Но если входящий поток стабильно превышает пропускную способность, очередь перестаёт быть амортизатором и становится накопителем беды.
Разберём, что физически происходит. Пусть сервис обрабатывает 1000 запросов в секунду, а приходит 1500. Каждую секунду в очереди оседает 500 «лишних» запросов. Очередь растёт линейно, и вместе с ней растёт время ожидания: запрос, попавший в хвост, ждёт, пока разгребут всё, что перед ним. Через несколько секунд время в очереди превышает клиентский таймаут — и вот здесь начинается самое разрушительное.
Клиент, не дождавшись ответа, обрывает соединение и, скорее всего, повторяет запрос (retry). Но сервис об этом не знает: протухший запрос всё ещё лежит в очереди и будет добросовестно обработан. Система тратит дефицитный ресурс — CPU, соединение к БД, слот пула — на работу впустую: считает ответ, который уже некому получить. Хуже того, retry добавляет новый запрос во входящий поток, усиливая перегруз. Это классическая петля положительной обратной связи, ведущая к коллапсу (congestion collapse).
Есть и второй, чисто ресурсный эффект. Неограниченный буфер в памяти растёт, пока не упрётся в предел — и тогда процесс убивает OOM killer или GC уходит в непрерывную сборку, роняя латентность всего инстанса. Один перегруженный компонент утаскивает за собой соседей.
Сетевики знают этот эффект под именем bufferbloat: избыточные буферы в сетевом тракте не улучшают пропускную способность, а лишь раздувают задержку, потому что пакеты долго ждут в очередях вместо того, чтобы быть честно отброшенными сигналом «перегруз». В прикладных системах ровно то же: большая очередь не увеличивает throughput (его определяет узкое место — обработчик), а только превращает быстрый честный отказ в медленную мучительную деградацию для всех.
Вывод, который переворачивает исходную интуицию: очередь должна быть ограничена. Не потому, что память дорога, а потому, что ограничение очереди — это точка, где система получает шанс осознанно решить, что делать с лишней нагрузкой, вместо того чтобы молча копить её до отказа. Дальше — два способа этим шансом распорядиться: притормозить источник (backpressure) или отбросить лишнее (load shedding).
Backpressure: сигнал «медленнее» вверх по цепочке
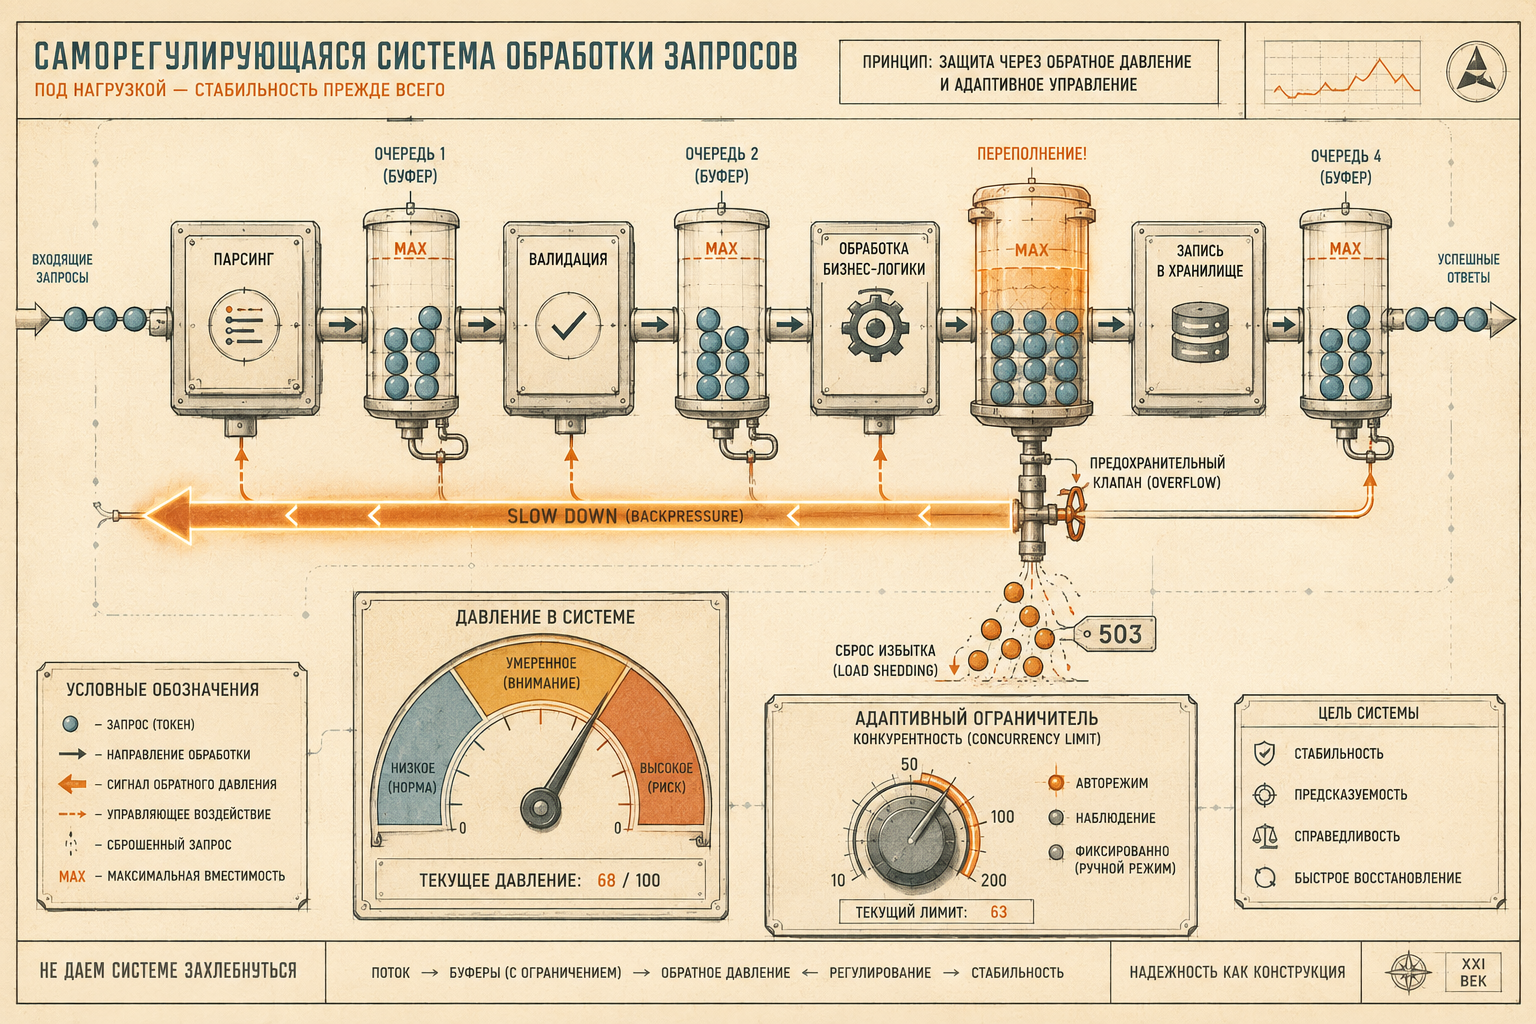
Backpressure (обратное давление) — это механизм, которым перегруженный потребитель сообщает поставщику: «притормози, я не успеваю». Сигнал распространяется вверх по цепочке — от медленного звена к источнику, — пока не дойдёт до того, кто способен сбавить темп: замедлить чтение из сокета, приостановить продюсера, отдать клиенту паузу.
Ключевой носитель этого сигнала — bounded queue, очередь фиксированного размера. Когда она заполнена, попытка положить в неё элемент не проходит мгновенно, и это «не проходит» и есть сигнал. У поставщика при переполнении есть три принципиальные реакции:
- Block — заблокироваться на записи и ждать свободного места. Давление естественно передаётся выше: пока продюсер ждёт, он не читает новую работу из своего источника, и тот, в свою очередь, тоже притормаживает. Так работает, например, синхронный конвейер горутин на небуферизованных каналах.
- Drop — отбросить элемент (самый старый или самый новый) и продолжить. Подходит там, где данные быстро устаревают: телеметрия, координаты, котировки — свежий отсчёт ценнее просроченного.
- Reject — отказать поставщику с явной ошибкой («перегружен, повтори позже»), переложив решение на него. На границе сервиса это превращается в честный HTTP 503.
Наглядно цепочка с ограниченными очередями и сигналом обратного давления выглядит так:
flowchart LR
    C[Клиент] -->|запросы| E[Edge / gateway]
    E -->|bounded queue| S[Сервис]
    S -->|bounded queue| W[Worker pool]
    W --> DB[(База данных)]

    W -. очередь полна .-> S
    S -. backpressure: медленнее .-> E
    E -. очередь полна .-> LS{{load shedding: 503}}
    LS -. быстрый отказ .-> C

    DB -. рост latency .-> W
В экосистеме реактивного программирования backpressure формализован спецификацией Reactive Streams: подписчик через request(n) явно сообщает издателю, сколько элементов готов принять, и издатель не имеет права отправить больше. Это pull-модель с ограничением спроса — противоположность наивному push, где издатель заливает потребителя, не спрашивая.
В Go тот же принцип выражается идиоматично через буферизованный канал. Небуферизованный или заполненный канал блокирует отправителя — это block-backpressure «из коробки»:
// Буфер ограничивает число задач «в полёте». Когда он полон,
// producer блокируется на отправке — давление уходит вверх по цепочке.
tasks := make(chan Task, 128)

// Producer: если consumer не успевает, send блокируется здесь,
// и producer перестаёт читать новую работу из своего источника.
go func() {
    for t := range source {
        tasks <- t // backpressure: ждём свободный слот
    }
    close(tasks)
}()

// Consumer: обрабатывает с той скоростью, на какую способен.
for t := range tasks {
    handle(t)
}
Block-стратегия хороша для внутренних конвейеров, где источник управляем и его не жалко притормозить. Но у неё есть предел: заблокированный отправитель — это удерживаемый ресурс (горутина, соединение), и если источник не притормаживается, а сам является клиентским запросом с таймаутом, блокировать его бессмысленно — лучше сразу отказать. Здесь backpressure переходит в load shedding.
Load shedding: сознательный сброс
Backpressure предполагает, что источник можно притормозить. Но входящий пользовательский трафик притормозить нельзя: у людей и внешних клиентов свои таймауты и свои retry, они не подчиняются вашему request(n). Когда давить некуда, остаётся честно отбросить часть нагрузки — это и есть load shedding.
Главный тезис здесь контринтуитивен ровно как и с очередью: лучше быстро отказать части запросов, чем медленно обслужить всех. Перегруженный сервис, который тянет каждый запрос, отдаёт всем недопустимую латентность и в итоге не выполняет ни одного вовремя. Сервис, который на входе отсекает лишнее и мгновенно отвечает 503, сохраняет нормальное время ответа для той доли трафика, которую реально способен обслужить. 503 за 2 мс — это не отказ ради отказа, это защита good-put (полезной пропускной способности) от обрушения.
Google SRE в главах про handling overload и addressing cascading failures описывает ровно эту дисциплину: сервис должен деградировать предсказуемо и отвечать отказом дёшево, а не пытаться героически обслужить перегруз и утащить за собой всю цепочку зависимостей.
Где сбрасывать. Есть два уровня, и обычно нужны оба:
- На входе (gateway / edge) — самый дешёвый сброс: отклонённый запрос не потратил ни байта на бизнес-логику. Хорошо ловит грубый перегруз и защищает всё, что за шлюзом.
- Внутри сервиса — там, где видно реальное состояние: длину рабочей очереди, занятость пула соединений к БД, наблюдаемую латентность. Только здесь можно сбрасывать избирательно, по приоритету запроса.
По какому сигналу. Абсолютный порог по RPS хрупок — «здоровые» 1000 rps сегодня при деградировавшей БД завтра станут перегрузом. Надёжнее судить по внутренним признакам насыщения: заполненность bounded-очереди, число запросов «в полёте», рост p99-латентности, исчерпание пула. Это те же сигналы, что использует adaptive concurrency (ниже).
Простейший сброс на bounded-очереди в Go — неблокирующая отправка через select с default:
// Request несёт КОНТЕКСТ запроса и канал результата. Контекст обязателен: без
// него воркер продолжит считать ответ для клиента, который уже ушёл, — ровно та
// работа впустую, из-за которой очередь и становится опасной. Канал буферизован
// на единицу, чтобы воркер не заблокировался, если получателя уже нет.
type Request struct {
    ctx     context.Context
    payload Payload
    result  chan Result
}

// worker берёт задачу и ПЕРЕД дорогой операцией проверяет, нужен ли ещё ответ.
func worker(work <-chan Request) {
    for r := range work {
        if r.ctx.Err() != nil {
            continue // клиент ушёл или истёк дедлайн — не тратим CPU и коннект к БД
        }
        r.result <- process(r.ctx, r.payload) // process тоже уважает отмену
    }
}

// admit пытается принять запрос в работу. Если рабочая очередь
// заполнена — не ждём, а сразу отклоняем: 503 быстро лучше, чем зависание.
func admit(work chan<- Request, r Request) error {
    select {
    case work <- r:
        return nil // приняли в обработку
    default:
        return ErrOverloaded // сброс: очередь полна, отдаём 503
    }
}

func handler(w http.ResponseWriter, req *http.Request) {
    r := Request{ctx: req.Context(), payload: parse(req), result: make(chan Result, 1)}
    if err := admit(workQueue, r); err != nil {
        w.Header().Set("Retry-After", "1")
        http.Error(w, "overloaded", http.StatusServiceUnavailable)
        return
    }
    // ResponseWriter действителен, только пока не вернулся ServeHTTP, поэтому
    // ответ дожидаемся здесь, а не пишем из воркера.
    select {
    case res := <-r.result:
        writeResult(w, res)
    case <-req.Context().Done():
        // клиент ушёл или истёк таймаут: воркер положит результат в буфер и не застрянет
    }
}
Разница с backpressure — в одной строке: default вместо ожидания. Отправитель не блокируется, а немедленно узнаёт об отказе и отдаёт клиенту быстрый 503 с Retry-After. Клиент с корректным backoff повторит позже, не добивая перегруженный сервис. Именно поэтому load shedding работает в паре с разумной retry-политикой на стороне клиента (jitter, ограничение попыток) — иначе сброшенные запросы вернутся лавиной.
Приоритезация и graceful degradation
Отбрасывать запросы вслепую расточительно: не весь трафик одинаково ценен. Оплата заказа важнее пересчёта блока рекомендаций; health-check важнее фоновой переиндексации. Поэтому зрелый load shedding — приоритетный: под перегрузом первыми уходят за борт необязательные и фоновые запросы, а критический путь защищается до последнего.
Практически это означает классификацию запросов по важности (criticality) на входе и раздельные бюджеты. Google SRE описывает это как метки criticality, которые пробрасываются по всей цепочке вызовов: перегруженный нижележащий сервис сбрасывает низкоприоритетное первым, независимо от того, кто это к нему прислал. Ту же идею дают отдельные пулы/очереди на класс трафика: у критичного — свой пул, который фоновые задачи не могут исчерпать (bulkhead, см. resilience-паттерны).
Graceful degradation — вторая половина той же медали. Вместо бинарного «ответ или отказ» система под нагрузкой отдаёт урезанный, но полезный результат:
- отдать закэшированную (возможно, слегка устаревшую) версию вместо свежего пересчёта — см. кэш-стратегииСкоро и, в частности, stale-while-revalidate;
- вернуть ответ без дорогой необязательной секции (персональные рекомендации, обогащение из медленного сервиса);
- понизить точность: приблизительный счётчик вместо точного, топ-10 вместо полного скана.
Смысл в том, что деградированный ответ почти всегда лучше ошибки, если он честно помечен как урезанный. Клиент получает работающий продукт, а система — сброс нагрузки на дорогих участках. Ключевое правило: деградация должна быть осознанным заранее спроектированным режимом, а не случайным побочным эффектом сбоя. Знать, какую секцию можно отключить и как, нужно до инцидента, а не во время.
Adaptive concurrency: динамический лимит
Bounded-очередь требует ответа на неудобный вопрос: а какой длины? И сколько запросов пускать в обработку параллельно? Статический лимит параллелизма — это компромисс, который всегда неправильный. Поставишь низкий — задушишь сервис, недоиспользуя ресурсы в спокойное время. Поставишь высокий — под деградацией зависимости (медленная БД) он пропустит слишком много, латентность обвалится, и лимит не спасёт. А «правильное» число меняется от железа, от нагрузки, от состояния соседей — вручную его не угадать и не удержать.
Adaptive concurrency решает это, подбирая лимит автоматически по наблюдаемой латентности. Идея опирается на закон Литтла (Little’s law), который качественно связывает три величины: среднее число запросов в системе (L) равно интенсивности входа (λ), умноженной на среднее время пребывания (W): L = λ · W. Если переписать относительно пропускной способности, λ = L / W, видно главное: при фиксированном числе одновременных запросов L рост времени обслуживания W означает падение пропускной способности λ. Растущая латентность — это ранний и надёжный признак, что система прошла точку насыщения и добавлять параллелизм вредно.
Алгоритм (его популяризировал Netflix в библиотеке concurrency-limits, идея восходит к алгоритмам управления перегрузкой TCP, таким как Vegas): непрерывно измерять latency, поддерживать оценку «минимальной» латентности (RTT без очередей) и текущей. Пока текущая близка к минимальной — очереди нет, лимит можно осторожно повышать. Как только latency растёт относительно базовой — значит, запросы начали ждать, система насыщается, лимит нужно снижать. Это gradient-подход: система сама нащупывает предел параллелизма, при котором throughput максимален, а очередь ещё не разрослась.
Оговорка про живой стенд: он реализует упрощённый пороговый AIMD-вариант этой идеи — растём аддитивно, а при скачке латентности сверх порога режем мультипликативно. Так нагляднее показать сам эффект (адаптивный лимит vs статический), но это не полноценный gradient-лимитер из Netflix concurrency-limits с оценкой minRTT — продакшн-реализацию берите из библиотеки, а не из демо.
Скелет такого ограничителя (упрощённо, без сглаживания и защит):
// AdaptiveLimiter подбирает лимит параллелизма по латентности:
// пока latency близка к базовой (RTT без очереди) — растём,
// как только latency растёт — сокращаемся.
type AdaptiveLimiter struct {
    mu       sync.Mutex
    limit    int           // текущий лимит параллелизма
    inFlight int           // запросов в работе прямо сейчас
    minRTT   time.Duration // оценка латентности без очередей
}

// Acquire пытается занять слот. false — перегруз, сбрасываем запрос.
func (l *AdaptiveLimiter) Acquire() bool {
    l.mu.Lock()
    defer l.mu.Unlock()
    if l.inFlight >= l.limit {
        return false // лимит исчерпан → load shedding
    }
    l.inFlight++
    return true
}

// Release возвращает слот и корректирует лимит по замеру RTT.
func (l *AdaptiveLimiter) Release(rtt time.Duration) {
    l.mu.Lock()
    defer l.mu.Unlock()
    l.inFlight--
    if rtt < l.minRTT || l.minRTT == 0 {
        l.minRTT = rtt
    }
    // Очередей нет (latency ~ базовой) — осторожно расширяемся.
    // Latency заметно выросла — сжимаемся (система насыщена).
    if rtt <= 2*l.minRTT {
        l.limit++
    } else if l.limit > 1 {
        l.limit--
    }
}
Красота подхода в том, что он не требует знать абсолютную ёмкость сервиса заранее и автоматически подстраивается под деградацию зависимостей: как только БД замедлилась, латентность выросла, лимит сжался — и сервис сам начал сбрасывать нагрузку, не дожидаясь, пока очередь взорвётся. Более строгий разбор связки очередей, латентности и ёмкости — в статье про теорию очередей и планирование ёмкостиСкоро.
Чем это отличается от rate limiting и circuit breaker
Backpressure и load shedding часто путают с соседними механизмами защиты — они решают разные задачи и срабатывают на разные сигналы.
| Механизм | От чего защищает | Сигнал срабатывания | Действие |
|---|---|---|---|
| Rate limiting | от конкретного клиента / abuse; несправедливое потребление | превышение заранее заданной квоты (rps, токены) | отказать этому клиенту (429), остальных не трогать |
| Backpressure | от переполнения внутри цепочки обработки | заполнение bounded-очереди | передать «медленнее» вверх: block / drop / reject |
| Load shedding | систему от суммарного перегруза (в т.ч. легитимного) | внутреннее насыщение (очередь, latency, in-flight) | сбросить часть трафика, приоритетно (503) |
| Circuit breaker | от падающей зависимости вниз по цепочке | доля ошибок/таймаутов к downstream превысила порог | перестать звать сломанный сервис, быстро падать (fail-fast) |
Разница по направлению и причине: rate limiting смотрит на источник и на заданную квоту («ты — слишком часто»); backpressure и load shedding смотрят на собственное насыщение («я не успеваю»), причём backpressure давит вверх на управляемый источник, а load shedding отбрасывает неуправляемый; circuit breaker смотрит вниз, на здоровье зависимости («тот, кого я зову, сломан»). Rate limiting отклоняет по превышению лимита даже здоровую систему; load shedding отклоняет, только когда система реально насыщена, независимо от того, легитимен ли трафик.
На практике они не конкурируют, а складываются в эшелонированную оборону: rate limiting на edge отсекает грубый abuse, adaptive concurrency и load shedding внутри защищают от суммарного перегруза, circuit breaker обрывает вызовы к упавшим зависимостям, backpressure держит внутренние конвейеры в границах. Подробнее про circuit breaker, bulkhead, retry и таймауты — в resilience-паттернах.
Checklist
- Все очереди ограничены. Ни одного неограниченного буфера в памяти на пути запроса — ни канала, ни пула задач, ни списка ожидания.
- Есть явная реакция на переполнение. Для каждой bounded-очереди решено и закодировано: block, drop или reject — не «как получится».
- Отказ быстрый и честный. Под перегрузом сервис отдаёт 503 за миллисекунды с
Retry-After, а не зависает на секунды. - Сброс идёт по сигналу насыщения, а не по абсолютному RPS. Ориентир — заполненность очереди, in-flight, рост latency, исчерпание пула.
- Трафик классифицирован по приоритету. Критический путь имеет защищённый бюджет (отдельный пул/очередь); фоновое сбрасывается первым.
- Спроектирован режим деградации. Заранее известно, какую секцию ответа можно отключить и что отдать из кэша.
- Лимит параллелизма адаптивный (или хотя бы осознанно выбранный и проверенный под деградацией зависимости), а не «на глаз навсегда».
- Клиенты умеют backoff. Retry с jitter и ограничением попыток, иначе сброшенное вернётся лавиной.
- Перегруз наблюдаем. Метрики: длина очередей, доля сброшенных (shed rate), текущий лимит, p99 latency. Без них сброс невидим.
Из практики
Три наблюдения, которые повторяются от системы к системе.
«Очередь побольше» всегда откладывает боль, а не убирает её. Увеличение буфера сдвигает момент отказа на пару минут и делает его хуже: когда он всё же наступает, в очереди лежат десятки тысяч протухших запросов, и система тратит минуты на обработку никому не нужной работы, прежде чем прийти в себя. Ограниченная очередь ломается раньше, но предсказуемо и с быстрым восстановлением.
Retry без backoff превращает load shedding в усилитель перегруза. Сервис честно отдаёт 503, а клиент, настроенный на «повторить сразу до 5 раз», мгновенно возвращает те же запросы пятикратно. Сброс без кооперации клиента не спасает — jitter и ограничение попыток на стороне клиента так же важны, как сам сброс.
Latency — более честный сигнал перегруза, чем RPS. Абсолютный порог по запросам в секунду устаревает при первой же деградации зависимости: вчерашние «безопасные» 1000 rps сегодня при подтормаживающей БД уже перегруз. Ограничитель, который смотрит на рост латентности, ловит это автоматически, без ручной перенастройки порогов.
Живой стенд — digital-cookbook/resilience/backpressure/: bounded-очередь (политики block/drop/reject), load shedding, адаптивный лимитер (AIMD) и демо-нагрузчики, печатающие good-put, латентность (p50/p99) и долю отказов под перегрузом. Пакеты покрыты тестами, весь модуль проходит go test -race -count=20. Конкретные числа снимайте прогоном — в статью они намеренно не вписаны.
Что дальше
Backpressure и load shedding — это дисциплина честного отказа: система, которая под перегрузом сохраняет полезную пропускную способность для той доли трафика, что реально способна обслужить, вместо героической попытки вытянуть всё и обрушить good-put для всех.
Продолжение темы в серии и рядом:
- Rate limiting и throttling — защита от конкретного клиента и распределённые счётчики.
- Resilience-паттерны — circuit breaker, bulkhead, retry, timeout как соседние эшелоны обороны.
- Кэш-стратегииСкоро — материал для graceful degradation (stale-while-revalidate и отдача устаревшего).
- Теория очередей и планирование ёмкостиСкоро — строгий разбор связки «очередь ↔ латентность ↔ ёмкость».
Первоисточники концепций:
- Reactive Streams specification — формализация backpressure через
request(n). - Google SRE Book — Handling Overload и Addressing Cascading Failures — load shedding, criticality, graceful degradation.
- Netflix concurrency-limits — adaptive concurrency по латентности (идея из TCP Vegas).


Комментарии