
Сервис с моделью выкатили, через неделю качество просело. Первый вопрос разбора — что именно сейчас в проде. Для кода ответ даёт git: коммит, diff, ревью. Модель так не прочитать: это бинарный файл, и два файла с разными байтами могут предсказывать одинаково, а два с одинаковым именем и версией — по-разному. Реестр моделей нужен, чтобы на вопрос «что обслуживается» был один ответ, — но только если версия модели описана целиком и сверяется с тем, что реально загружено.
Вторая статья серии «Классический ML в проде». В первой статье признак разошёлся между обучением и инференсом; здесь — модель целиком: из чего состоит её версия, что ломается при рассинхроне частей, что даёт реестр и где его ответ перестаёт быть правдой.
Стенд: digital-cookbook/ai/ml-registry, датасет серии — digital-cookbook/ai/ml-dataset. Нужны Docker и Python; PostgreSQL, сервер MLflow и контейнер измерений работают в одной сети. Версии: MLflow 3.16.1, DVC 3.67.1, scikit-learn 1.9.1, skops 0.16.0; для проверки версий библиотеки — scikit-learn 1.8.0, 1.7.2 и 1.6.1 в отдельных окружениях.
В статье
- Что версионируется на самом деле
- Формат артефакта и версия библиотеки
- Реестр как источник правды
- Стадии, алиасы и что обслуживается на деле
- Версионирование данных: DVC и lakeFS
- Чем платим
- Что из этого следует
Что версионируется на самом деле
Модель из датасета серии — градиентный бустинг, который оценивает платёж на мошенничество. Его «версия» — это не файл с деревьями, а пять частей, и каждая влияет на оценку:
| часть | пример расхождения |
|---|---|
| веса | артефакт другого прогона обучения |
| код препроцессинга | логарифм суммы при обучении, сырая сумма в сервинге |
| набор и версии признаков | средняя за 14 дней при обучении, за 30 — в сервинге |
| версии библиотек | артефакт scikit-learn 1.9 под 1.6 |
| срез данных | на один день обучения больше |
Обслуживается при этом не оценка, а решение: флаг ставится, если оценка выше порога. Поэтому у версии решения есть шестая часть — политика: порог, калибровка оценок, если она есть, и правила деградации из третьей статьиготовится, с 25 ноября. При тех же весах и признаках другой порог даёт другие решения, а scikit-learn прямо разделяет оценку вероятности и действие по ней.
Стенд пишет каждый прогон обучения в MLflow: параметры, срез данных с дайджестом, модель в формате по умолчанию.
# stand/measure.py
def log(model, X, y, run_name, params, tags=None):
    """Прогон обучения: параметры, срез данных с дайджестом, модель в формате по умолчанию."""
    with mlflow.start_run(run_name=run_name) as run:
        mlflow.log_params(params)
        if tags:
            mlflow.set_tags(tags)
        mlflow.log_input(mlflow.data.from_numpy(X, targets=y, name=run_name), context="training")
        info = mlflow.sklearn.log_model(model, name="model", input_example=X[:2], pyfunc_predict_fn="predict_proba",
                                        skops_trusted_types=TRUSTED)
Дальше — по одной части за раз, против базовой модели, на платежах дней 90–99. Контроль первым: модель, прочитанная из реестра, предсказывает побитово как модель в памяти, а несуществующий алиас даёт ошибку, а не «последнюю версию».
$ python3 scripts/run-checks.py controls
{"variant": "controls", "outcome": "match", "detail": "модель из реестра предсказывает как в памяти: да; несуществующий алиас — RestException; артефакт по умолчанию — model.skops; сохранение без skops_trusted_types — MlflowException"}
$ python3 scripts/run-checks.py five_parts
{"variant": "five_parts", "outcome": "match", "detail": "на 26052 запросах прода: те же входы — предсказания совпали: да, другие байты у MLmodel, model.skops; срез на день больше — перевёрнуто 135, дайджест данных другой: да; признак за 14 дней вместо 30 при старом в сервинге — 107; препроцессинг отдельно от модели — 978, внутри пайплайна — 0"}
| что изменено | перевёрнуто решений из 26 052 |
|---|---|
ничего: те же данные, код и библиотеки (другие байты: MLmodel, model.skops) |
0 |
| срез данных: на день обучения больше | 135 |
| признак: средняя за 14 дней при обучении, за 30 в сервинге | 107 |
| препроцессинг вне артефакта, сервинг его не применил | 978 |
тот же препроцессинг внутри Pipeline |
0 |
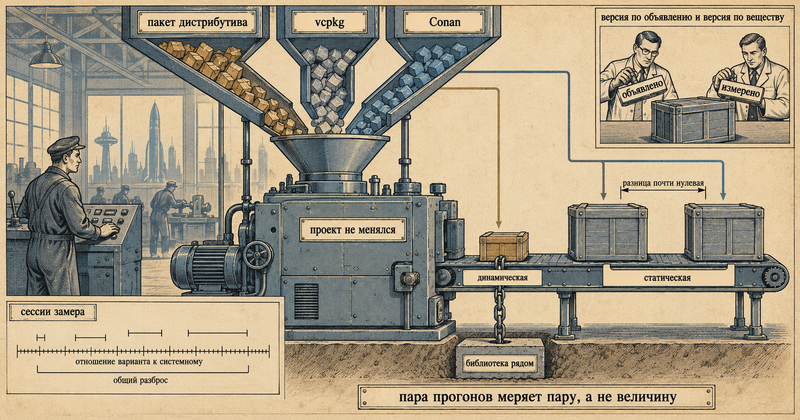
Первая строка — главная для эксплуатации. Обучение повторено на тех же
данных, тем же кодом, той же версией библиотеки: предсказания на
проверочной выборке совпали побитово, а байты артефакта — нет. В
MLmodel другие идентификатор прогона и время создания, архив skops
записан с другим временем. Хеш идентифицирует конкретный доставленный
артефакт — и для этого он незаменим, — но не служит устойчивым
идентификатором воспроизводимого обучения или эквивалентного поведения:
одно и то же обучение, упакованное дважды, даёт разные хеши. Для релиза
нужны оба: дайджест артефакта — что именно доставлено, и происхождение —
прогон, срез данных, версия кода признаков и препроцессинга, версии
библиотек. Реестр полезен ровно настолько, насколько эта связка в нём
записана.
Остальные строки — рассинхрон, который не даёт ни одной ошибки.
Препроцессинг, вынесенный из артефакта, — худший случай: модель училась
на логарифме суммы, сервинг подаёт сырую, деревья сравнивают с порогами
из другой шкалы. Тот же препроцессинг внутри Pipeline уезжает вместе с
моделью, и расхождение исчезает:
# stand/measure.py
    pipe = make_pipeline(FunctionTransformer(prep_v2), fit(prep_v2(X), y))
Версия признака — тот же класс проблемы, что train/serve skew из первой
статьи, только теперь она видна как вопрос версии: модель обучена на
«средней за 14 дней», сервинг отдаёт «среднюю за 30». Её не упаковать в
Pipeline, потому что признак считается вне модели; версия определения
признака должна быть записана в прогоне и сверяться с тем, что отдаёт
feature store. Срез на день больше — не ошибка, а другая модель:
переворот решений здесь — нормальное различие версий, и именно поэтому
срез обязан быть записан, иначе «та же модель» на разборе окажется не той.
Шестая часть — политика — проверяется отдельно: та же модель, тот же вход, порог на 1 % флагов посчитан по другому окну валидации.
$ python3 scripts/run-checks.py decision_policy
{"variant": "decision_policy", "outcome": "match", "detail": "та же модель на 26052 запросах прода: порог 1 % флагов по валидации 75–89 — 0.1599, по окну 60–74 — 0.1287; перевёрнуто решений 7"}
Решений переворачивается немного, но ни артефакт, ни его хеш, ни прогон обучения при этом не менялись. Порог живёт в конфигурации сервиса, и если он не входит в версию, его смена — релиз без релиза: без ревью, без отката и без записи в реестре.
Формат артефакта и версия библиотеки
В MLflow 3 модель scikit-learn по умолчанию сохраняется не в pickle, а в
skops — формат, который при загрузке не исполняет произвольный код, а
восстанавливает объекты по списку доверенных типов. Загрузка pickle
запрещена, пока не выставлена MLFLOW_ALLOW_PICKLE_DESERIALIZATION.
Первое следствие проявилось ещё до опыта: HistGradientBoostingClassifier
не сохраняется вовсе.
The saved sklearn model references untrusted types. If you are sure loading these types is safe, set the ‘skops_trusted_types’ parameter when calling ’log_model’ or ‘save_model’ to the list of trusted types. Root error: Untrusted types found in the file: [‘sklearn.ensemble._hist_gradient_boosting.predictor.TreePredictor’].
Ниже в том же сообщении объяснено почему: узлы деревьев хранят индексы,
по которым scikit-learn обращается без проверки границ, и подложенный файл
может обрушить процесс на predict. Доверие выдаётся явно и одному типу —
так и сделано в стенде. Это правильное поведение по умолчанию: артефакт
модели — исполняемая сущность, и загрузка чужого pickle — исполнение
чужого кода.
Второе следствие — версия библиотеки. Артефакт из scikit-learn 1.9.1 открыт тремя более старыми версиями в отдельных окружениях с тем же numpy.
$ python3 scripts/run-checks.py library_version
{"variant": "library_version", "outcome": "match", "detail": "модель из scikit-learn 1.9.1; 1.8.0: с тем же списком доверия — error, с типами scikit-learn из сообщения — loaded, предсказания совпали: да, InconsistentVersionWarning: да; 1.7.2: с тем же списком доверия — error, с типами scikit-learn из сообщения — loaded, предсказания совпали: да, InconsistentVersionWarning: да; 1.6.1: с тем же списком доверия — error, с типами scikit-learn из сообщения — loaded, предсказания совпали: да, InconsistentVersionWarning: да; версия закреплена в requirements.txt артефакта: да"}
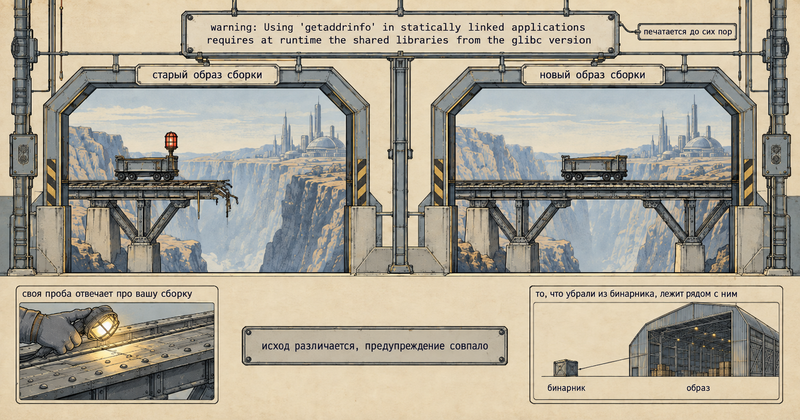
С тем же списком доверия артефакт не открылся ни в одной старой версии: skops сообщил ещё один недоверенный тип — функцию потерь самого scikit-learn; под 1.9.1 доверять ей явно не требовалось, под старыми версиями — требуется. Список доверия, таким образом, тоже зависит от версии библиотеки. С этим типом артефакт загрузился во всех трёх версиях, с предупреждением на каждый оценщик:
Trying to unpickle estimator HistGradientBoostingClassifier from version 1.9.1 when using version 1.6.1. This might lead to breaking code or invalid results. Use at your own risk. For more info please refer to:
Предсказания в этом опыте совпали побитово. Это свойство этой модели и
этих версий, а не обещание: предупреждение прямо говорит, что результат
может быть неверным, и проверять его надо на каждой паре версий. Защита
одна — сервинг поднимается в окружении из артефакта: MLflow записывает
рядом с моделью requirements.txt с точной версией scikit-learn, и
окружение сервинга собирается из него, а не «из того, что стоит».
Реестр как источник правды
Реестр поверх прогонов — именованная модель с нумерованными версиями,
каждая из которых ссылается на прогон и его артефакт. Ссылки на «текущую»
версию в MLflow — алиасы: models:/fraud@champion разрешается в номер
версии в момент обращения. Стадии Staging и Production, на которых
строились старые процессы выкатки, устарели с MLflow 2.9 и в 3.16 по-прежнему
работают, но каждое обращение к ним даёт FutureWarning.
$ python3 scripts/run-checks.py registry
{"variant": "registry", "outcome": "match", "detail": "алиас разрешается: да; стадии работают: да, предупреждение — FutureWarning"}
Что реестр даёт: один ответ на вопрос «какая версия должна обслуживаться»,
историю версий модели и связь каждой версии с прогоном — параметрами,
срезом данных, артефактом и его окружением. Чего реестр не даёт.
Во-первых, знания о том, что действительно загружено в процессах
сервинга, — об этом следующий раздел. Во-вторых, истории продвижений:
алиас в MLflow хранит текущее назначение — в хранилище на SQL это строка
«модель, алиас, версия», которая перезаписывается, без времени и без
прошлых значений. Какая версия была champion и когда, реестр не
ответит; для этого нужен отдельный журнал событий выкатки — кто, когда,
с какой версии на какую и по какой причине.
Стадии, алиасы и что обслуживается на деле
Стенд поднимает два обслуживания по алиасу champion, пока он указывает
на v1: штатный mlflow models serve и своё, которое при старте
запоминает, во что разрешился алиас. Потом алиас переносят на v2.
# stand/serve.py
mv = MlflowClient().get_model_version_by_alias(name, alias)
model = mlflow.sklearn.load_model("models:/%s/%s" % (name, mv.version))
LOADED = {"name": name, "alias": alias, "version": mv.version, "run_id": mv.run_id}
$ python3 scripts/run-checks.py stages
{"variant": "stages", "outcome": "match", "detail": "алиас champion перенесён на v2, реестр говорит v2; запущенный mlflow models serve отдаёт v1: да, v2: нет; после перезапуска — v2: да; /version отдаёт версию MLflow: да; сверка «загружено против алиаса»: до переноса — да, после — нет, после перезапуска — да; у прежней версии после переноса след алиаса есть: нет"}
Реестр говорит «champion — v2», запущенный сервинг продолжает отдавать
предсказания v1 — до перезапуска. Это не дефект MLflow: алиас разрешается
при загрузке, и процесс, загрузивший модель, о переносе не узнаёт. Но
штатный сервинг не помогает это заметить: его /version возвращает
версию самого MLflow, а не загруженной модели. На вопрос «что
обслуживается» отвечает только сам процесс сервинга, если его научить:
своё обслуживание отдаёт /loaded, и сверка «загружено против алиаса»
расходится сразу после переноса и сходится после перезапуска.
Отсюда практика выкатки: перенос алиаса — это запрос на выкатку, а не сама выкатка. Её завершает перезапуск или перезагрузка модели в каждом экземпляре, а подтверждает сверка: каждый экземпляр сообщает версию и прогон, мониторинг сравнивает их с реестром и алертит на расхождение. Как выглядит такая выкатка без простоя — в статье о выкатке без простоя; как устроено само обслуживание — в следующей статье серииготовится, с 25 ноября.
Версионирование данных: DVC и lakeFS
Срез данных — пятая часть версии, и записать его дайджестом в прогоне
мало: чтобы воспроизвести модель, нужны сами данные. DVC хранит данные в
своём кеше по содержимому, а в git кладёт маленький указатель — файл
.dvc с хешем. Стенд делает две версии датасета: во второй пришли
поздние chargeback, у десяти платежей поменялась метка, признаки те же.
$ python3 scripts/run-checks.py data_versioning
{"variant": "data_versioning", "outcome": "match", "detail": "датасет 59.7 МБ; DVC: кеш после двух версий 91.0 МБ (изменённый файл целиком, неизменный — один раз), git с указателями 29 КБ; откат восстановил байты: да, модель из них совпала: да; тот же датасет прямо в git — 23.0 МБ, после gc 13.4 МБ"}
Откат указателя и dvc checkout вернули байты первой версии, и модель,
обученная из них, совпала с обученной до версионирования. Кеш хранит
изменённый файл целиком на каждую версию, а неизменный — один раз:
дедупликация по файлам, а не по содержимому внутри файла.
Деталь, которую в споре «данные в git или нет» обычно упускают, — тот же датасет прямо в git. Для
текстового CSV с правкой в десяти строках git после gc хранит две версии
компактнее кеша DVC: дельта-сжатие работает. Поэтому аргумент против
«датасета в git» — не объём хранения как таковой, а всё остальное: лимиты
хостинга на размер файла, клон всей истории каждым разработчиком, бинарные
колоночные форматы, которые сжимаются дельтами плохо (в стенде не
проверялось), и данные, которые живут в хранилище, а не в репозитории.
lakeFS решает ту же задачу на уровне хранилища: ветки и коммиты над объектным хранилищем, без копирования данных в отдельный кеш; модель ссылается на коммит lakeFS так же, как на хеш DVC. В стенде lakeFS не проверялся.
Чем платим
- Дисциплина записи всех шести частей. Реестр знает только то, что записали: срез данных, версию определения признаков, версию кода препроцессинга, порог и правила деградации. Пропущенная часть всплывает на разборе как «та же модель ведёт себя иначе».
- Хранение. Каждая версия модели и данных — полная копия изменённых файлов; нужен ретеншен: какие версии хранить, пока на них ссылается прогон в реестре.
- Сверка сервинга с реестром. Отдельная метрика и алерт «загружено не то, что объявлено» — без них стадии и алиасы остаются метками.
- Окружение как часть артефакта. Сервинг собирается из
requirements.txtмодели, а список доверенных типов skops — часть ревью при смене версии библиотеки.
Что из этого следует
- Версия решения — шесть частей: веса, препроцессинг, признаки, библиотеки, данные и политика с порогом. Любая из них переворачивает решения без единой ошибки.
- Хеш идентифицирует доставленный артефакт, но не воспроизводимое обучение: те же входы дают те же предсказания и другие байты. Для релиза — и дайджест, и происхождение.
- Препроцессинг — внутрь артефакта (
Pipeline); версия признаков — в прогон и в сверку с feature store. - skops по умолчанию требует явного доверия к типам, и список зависит от версии scikit-learn. Сервинг собирается из окружения артефакта.
- Алиас — запрос на выкатку и текущее назначение без истории. Что
обслуживается, знает только процесс сервинга; штатный
/versionотвечает про MLflow. Нужны сверка «загружено против реестра» и отдельный журнал продвижений. - Данные версионируются вместе с моделью: DVC восстанавливает срез побайтно. Довод против данных в git — не объём, а хостинг, клон и форматы.
Следующая статья серии — онлайн-инференс: латентность, батчинг и отказыготовится, с 25 ноября.
Документация и первоисточники
- MLflow — Model Registry (алиасы, переход со стадий), scikit-learn flavor, Serving.
- skops — Secure persistence.
- scikit-learn — Tuning the decision threshold.
- scikit-learn — Model persistence
(
InconsistentVersionWarning, совместимость версий). - DVC — Versioning data and models.
- lakeFS — документация — не проверялся.
Обсуждение в Telegram
Присоединиться →